

数据平台整体性能提升
综合成本下降
美的楼宇科技事业部(以下简称楼宇科技)是美的集团旗下五大板块之一,产品覆盖多联机组、大型冷水机组、单元机、机房空调、扶梯、直梯、货梯以及楼宇自控软件和建筑弱电集成解决方案,远销海内外 200 多个国家。
当前设备数据量庞大且持续增长、数据呈现半结构化特点的现状,现有系统仅停留在数据存储和基础使用层面,缺乏深度挖掘数据价值的能力,导致大量潜在信息未被充分利用。因此,迫切需要构建一个统一且通用的 IoT 数据平台,平台要具备高度的弹性和轻量化特性,还应具备强大的大规模数据处理能力以及数据科学和 AI 技术支持,以实现快速的数据分析与智能化挖掘,推动楼宇系统的智能化升级,支持节能、设备管理和运维等方面的精确决策。
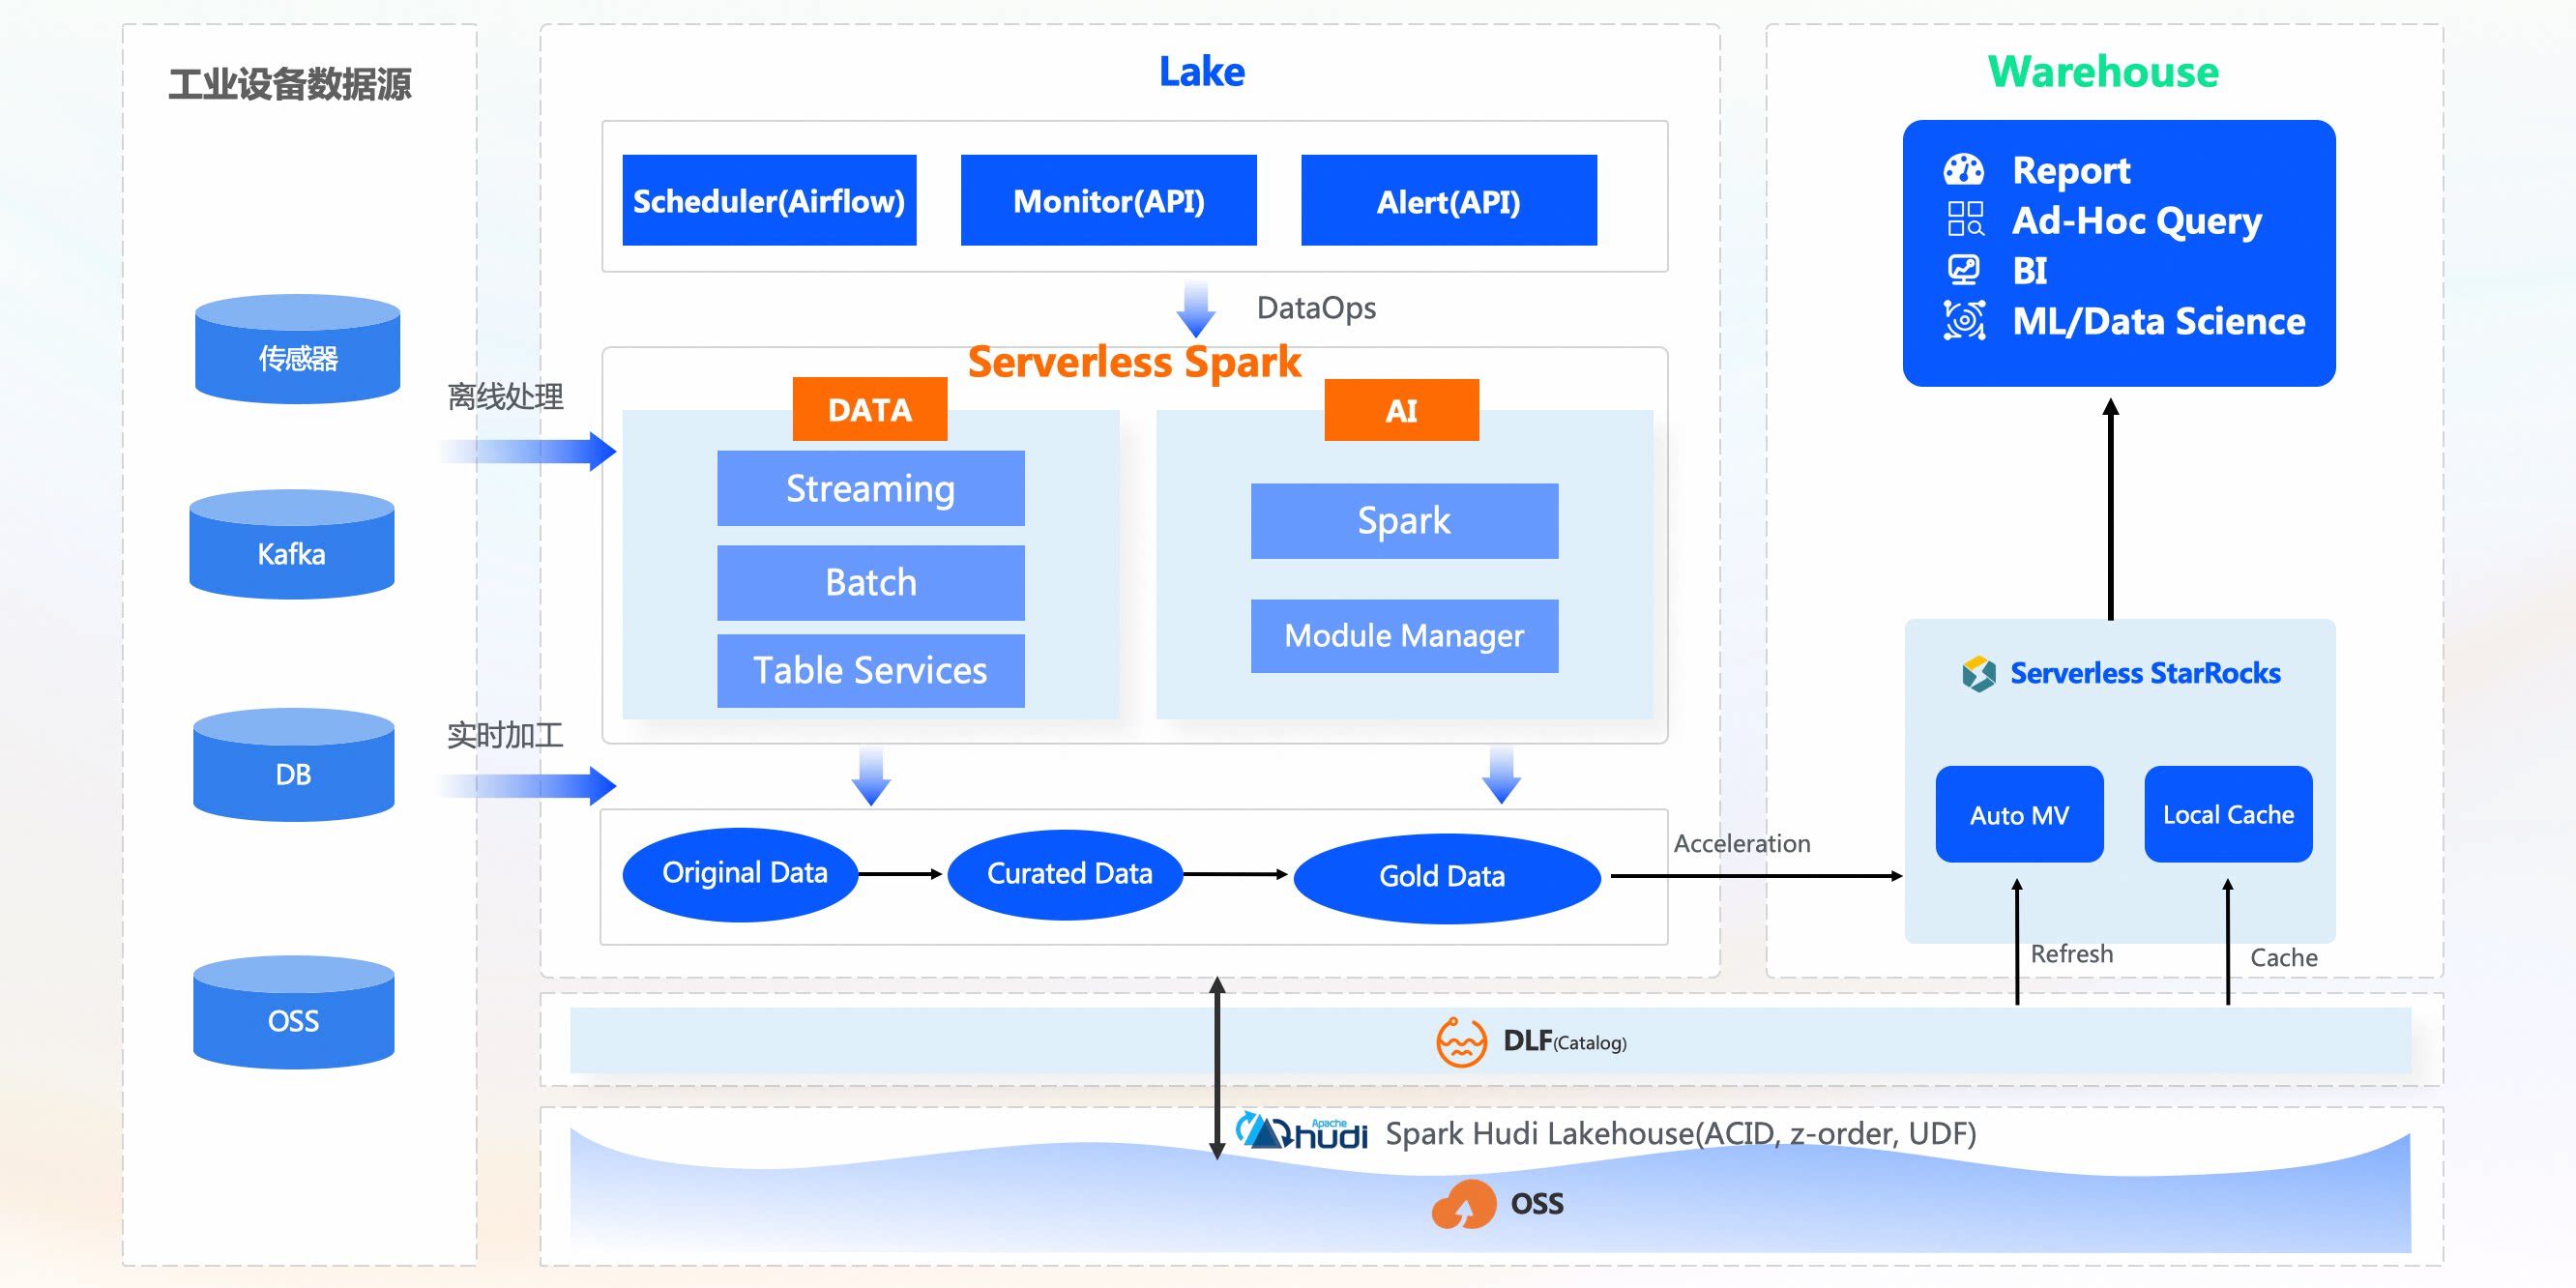
在 AI 应用方面,楼宇科技通过 Serverless Spark PySpark 任务,并基于 PyArrow UDF 调用自研算法实现了千亿级别数据在百万级维度的聚合,推动了 Data + AI 技术在实际业务中的应用。处理后的指标数据从数据湖中被加载到 StarRocks 中,为上层应用提供 Dashboard 和报表支持,提升了数据的可视化和决策能力。
以下架构图展示了如何利用 Serverless Spark 结合开源湖格式 Hudi、ML/AI 的多种工具库,以及阿里云 DLF 统一湖仓管理平台,实现高效的数据处理和 AI 赋能,使用 Serverless StarRocks 实现极速数据分析,为业务应用带来显著的提升。
EMR Serverless Spark 解决了以下痛点
-
自建集群 PoC 测试需要花费大量的成本,周期也比较长。
-
针对千亿级别的 IoT 设备上报数据,引擎性能非常关键。对原始数据做一轮点位提取(t+1 处理),用于后续数据开发和分析,每日的点位提取需要在短时间内运行大量资源对湖原始数据进行查询和处理。
-
需要完善的 Spark 生态,来实现全链路数据流转,来满足批、流、交互式、机器学习等不同场景需求。
-
弹性计算能力,需要一次性支持大规模计算,缩短数据使用延迟。多联机能耗运行月度报告生成的过程中,每月 5 号之前需要大量资源去生成上月的月度报告指标。
-
Data+AI 场景的支持能力。
简化了 IoT 数据链路
美的楼宇科技接入的 IoT 数据分为两部分,历史存量数据和实时数据。目前,历史存量数据是通过 Spark SQL 以天为单位从不同客户关系数据库批量导入 Hudi Lake 表中;实时数据通过 IoT 平台采集到云 Kafka,经由 Spark Structured Streaming 消费后实时写入到 Hudi Lake 表中。在这个过程中,美的楼宇将实时数据和历史数据都 sink 到同一张 Hudi 表里,这种批流一体操作可大大简化 ETL 流程。数据管道下游,对接数据分析及数据科学工作流。
美的楼宇科技基于阿里云 EMR Serverless Spark 技术栈快速构建了 IoT 数据处理平台,Serverless Spark 全托管免运维、自研 Fusion 引擎,内置高性能向量化计算和 RSS 能力,相比开源版本 3 倍以上的性能优势以及计算/存储分离的架构,为企业有效节省了总体成本。同时,EMR Serverless Spark 自身的丰富特性,也极大提升了企业数据团队的生产力,为数据分析业务的快速开展交付奠定了基础。