
CPU 消耗下降约
内存消耗下降约
知衣科技是一家时尚数据 AI 平台,致力于推动 AI 与大数据技术在服装产业链的深度落地。公司围绕趋势发现、爆款挖掘与内容营销等核心场景,为服装企业提供全链路数智化解决方案,业务覆盖海内外,累计服务客户近万家,旗下拥有知衣、知款、抖衣、海外探款、FD+ 及知小衣等多元化数据智能 SaaS 与 AI 创新应用。
知衣科技在面向跨境电商商家的服务中,需要将商品图与海外社媒内容进行全量匹配,基于商品与达人内容的关联结果为选品决策提供依据,但在规模化落地过程中面临严峻挑战:
-
图像主体定位难:达人发布的场景化图片与商品侧图片直接计算相似度,结果易受非主体元素干扰,需先对两侧图片分别执行服装区域检测,裁剪出主体商品后再进入特征提取环节。
-
全量交叉匹配的算力压力极大:单轮检索中,商品侧约 1000 万条 512 维向量需与约 200 万条社媒侧查询向量完成全量匹配。原有方案在大规模数据下算力压力巨大,难以支撑高频次的全量重跑。
-
检索成本制约业务边界:受限于高昂的算力成本,检索环节被迫在内容池覆盖规模、数据新鲜度与成本之间做取舍,限制了业务的进一步拓展。
知衣科技与阿里云大数据 AI 平台合作,确立了“自研模型负责理解、MaxCompute 负责检索”的技术分工,在保留客户自研模型资产的前提下,重构了检索环节。
-
数据清洗与图像预处理:海外社媒平台的公开博文内容经过集中清洗后,社媒图片与商品图分别执行服装区域检测,裁剪出主体商品区域,排除人物、背景与配饰对后续特征提取的干扰。
-
特征向量生成,保留自研模型资产:裁剪后的图像由知衣科技自研 CV 模型完成打标与特征向量提取,模型自主训练、自主部署,运行在 GPU 集群上,知衣科技在服装识别领域积累的模型资产与调优经验得以完整保留。
-
迁移至 MaxCompute 向量:知衣科技将原有的 Proxima 检索方案替换为 MaxCompute 提供的离线向量检索能力。向量数据直接写入 MaxCompute 内,无需跨平台搬迁。通过标准的 VECTOR_SEARCH SQL 函数完成向量批量相似度匹配,索引由系统自动构建维护,显著降低了运维成本。从验证到生产上线约两周完成切换,相同数据规模下资源消耗显著下降。
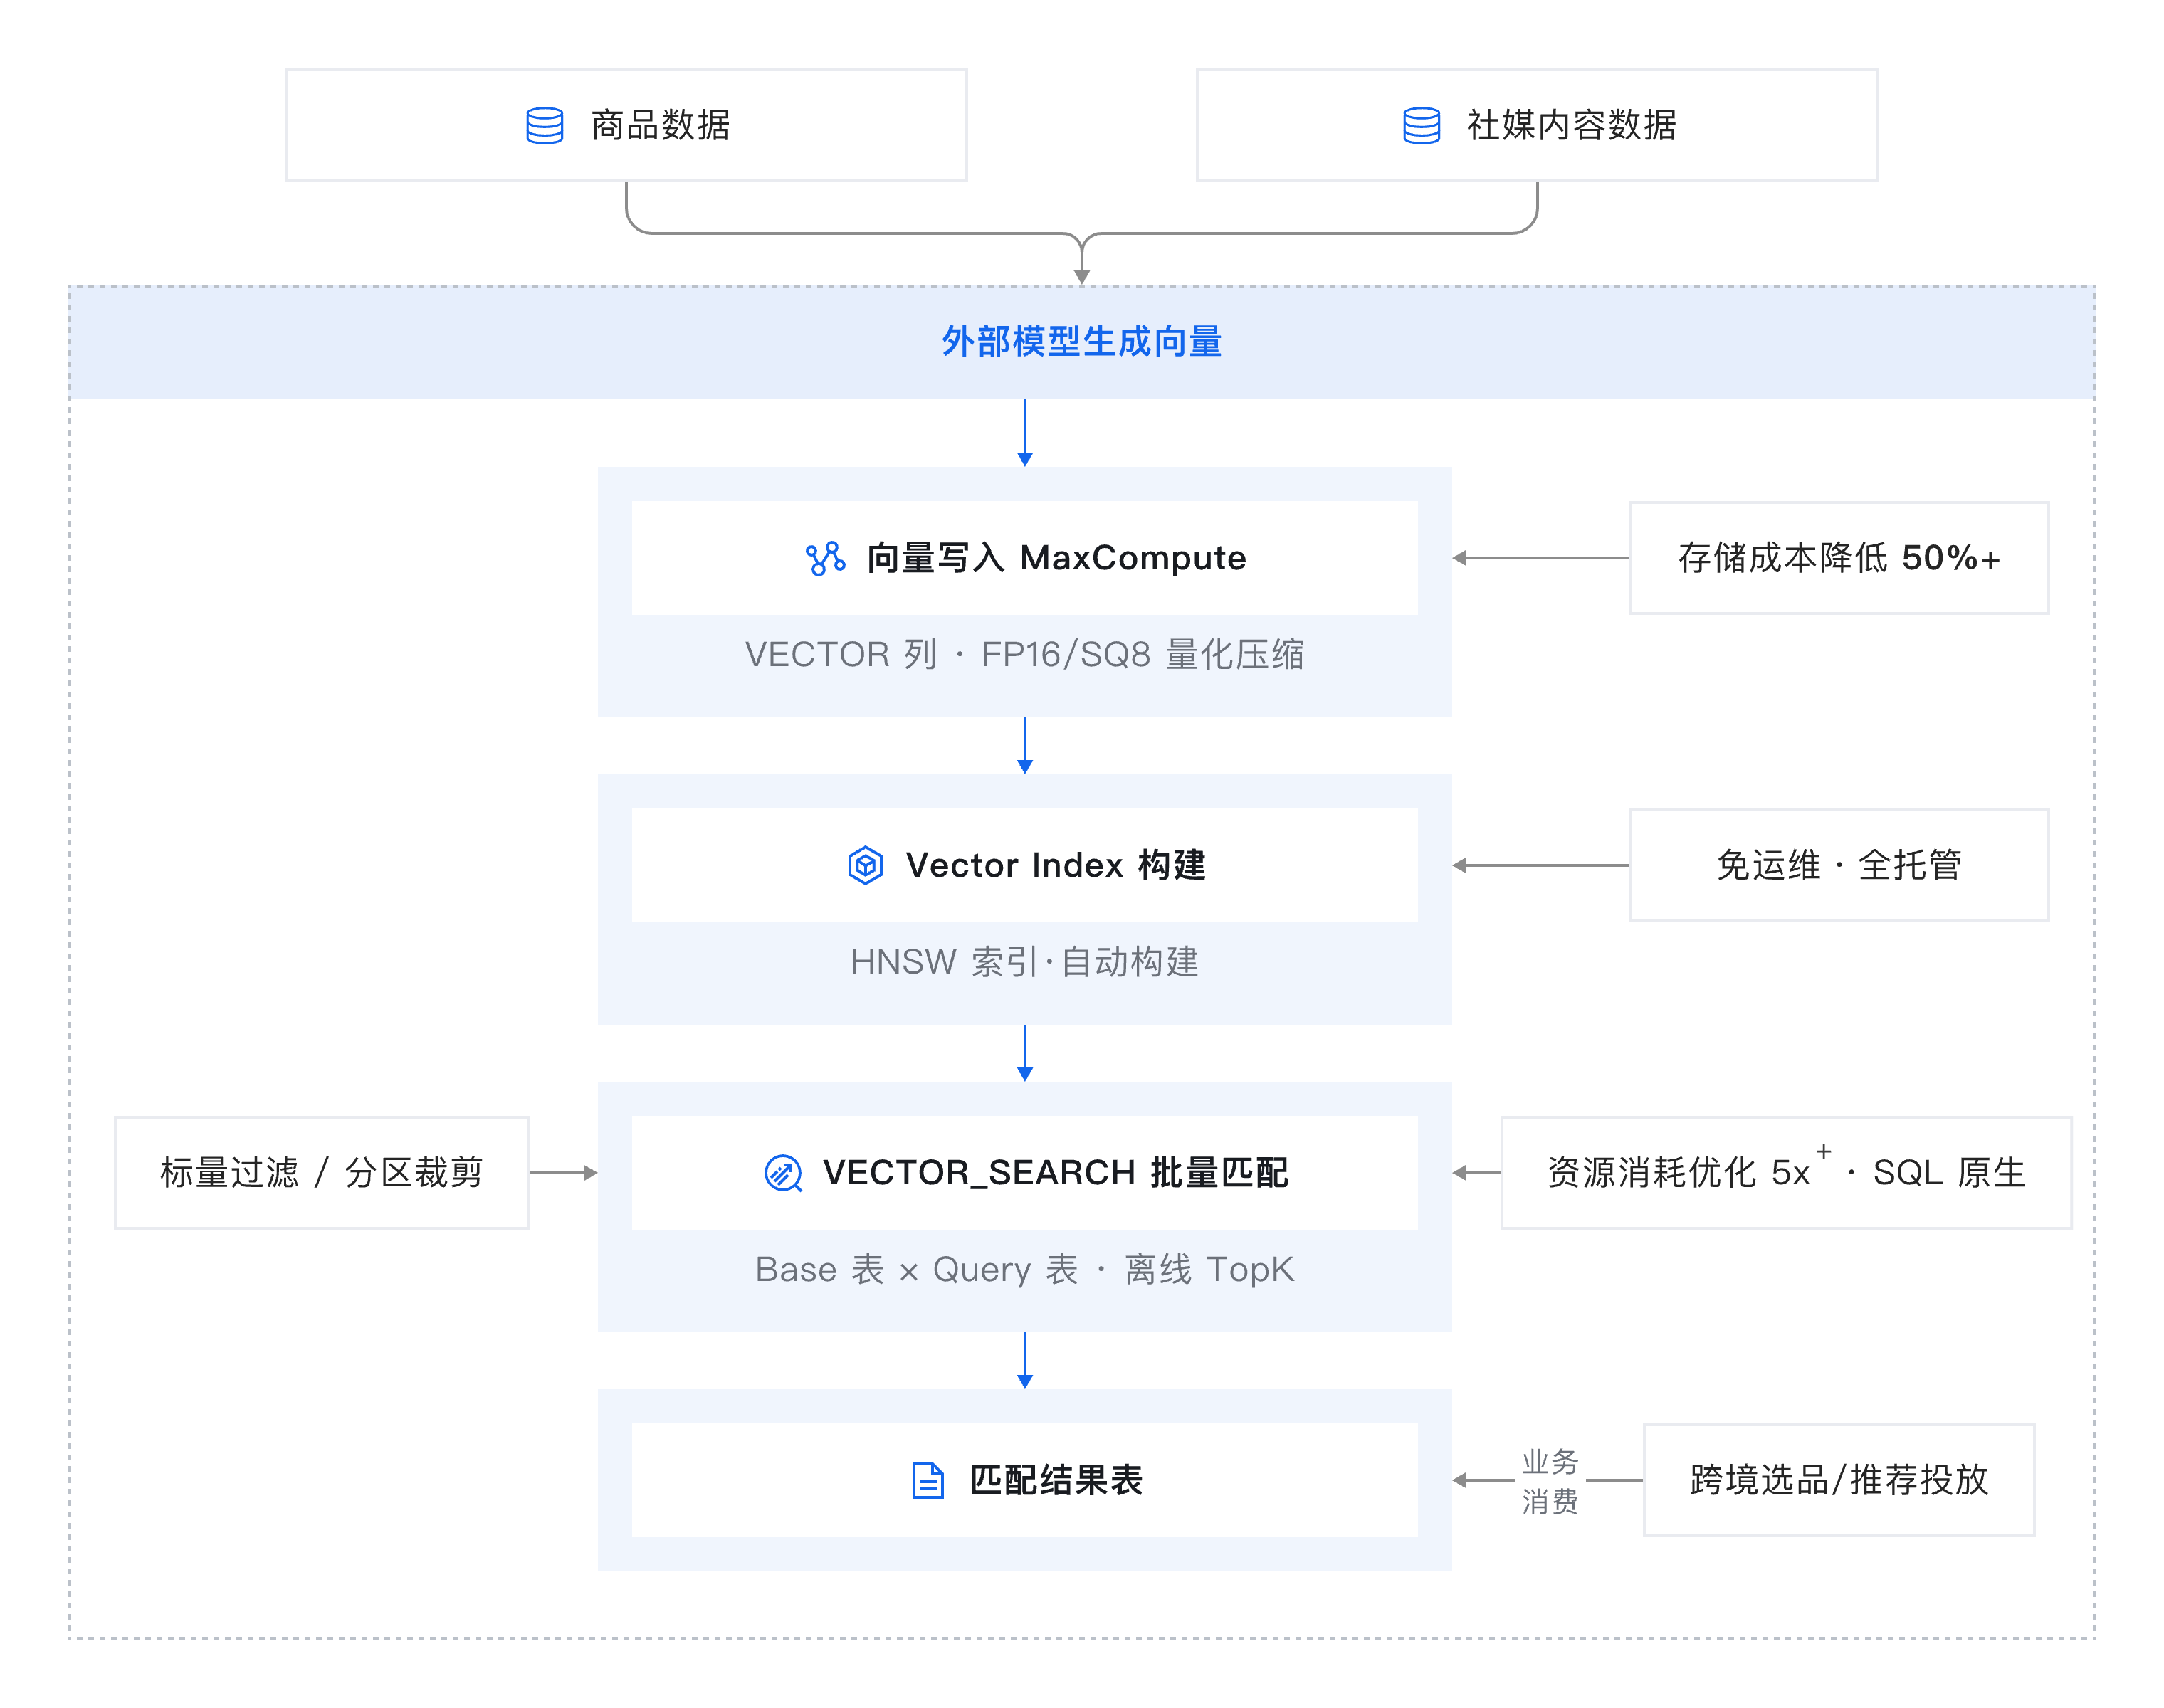
基于 MaxCompute 向量检索构建的检索链路上线后,成功解决了大规模向量检索的算力与成本问题,使商家能够以较低的资源开销实现更高频率的全量匹配,让站外真实热度成为跨境选品的常规指标。
-
资源消耗大幅下降:在商品侧约 1000 万条、社媒侧约 200 万条 512 维向量的相同检索规模下,以 Proxima 最近 14 次运行的均值为基准,MaxCompute 离线向量检索的 CPU 消耗下降约 73%,内存消耗下降约 93%。
-
运维成本大幅降低:不再需要维护独立的向量检索基础设施,大规模批量向量检索交由平台承接,知衣科技算法团队得以将精力集中在服装款式特征向量的提取能力上,持续强化自研 CV 模型在服装识别领域的优势。
-
业务价值显著提升:检索成本的大幅下降使商家在相同预算下可覆盖更大的内容池、以更高频率重跑全量匹配,商品-达人关联结果保持实时更新。选品决策从此前依赖站内销售数据、站外热度只能靠零散截图佐证,升级为可在产品中持续观测款式在海外社媒的达人传播情况,为客户选品决策提供依据。