
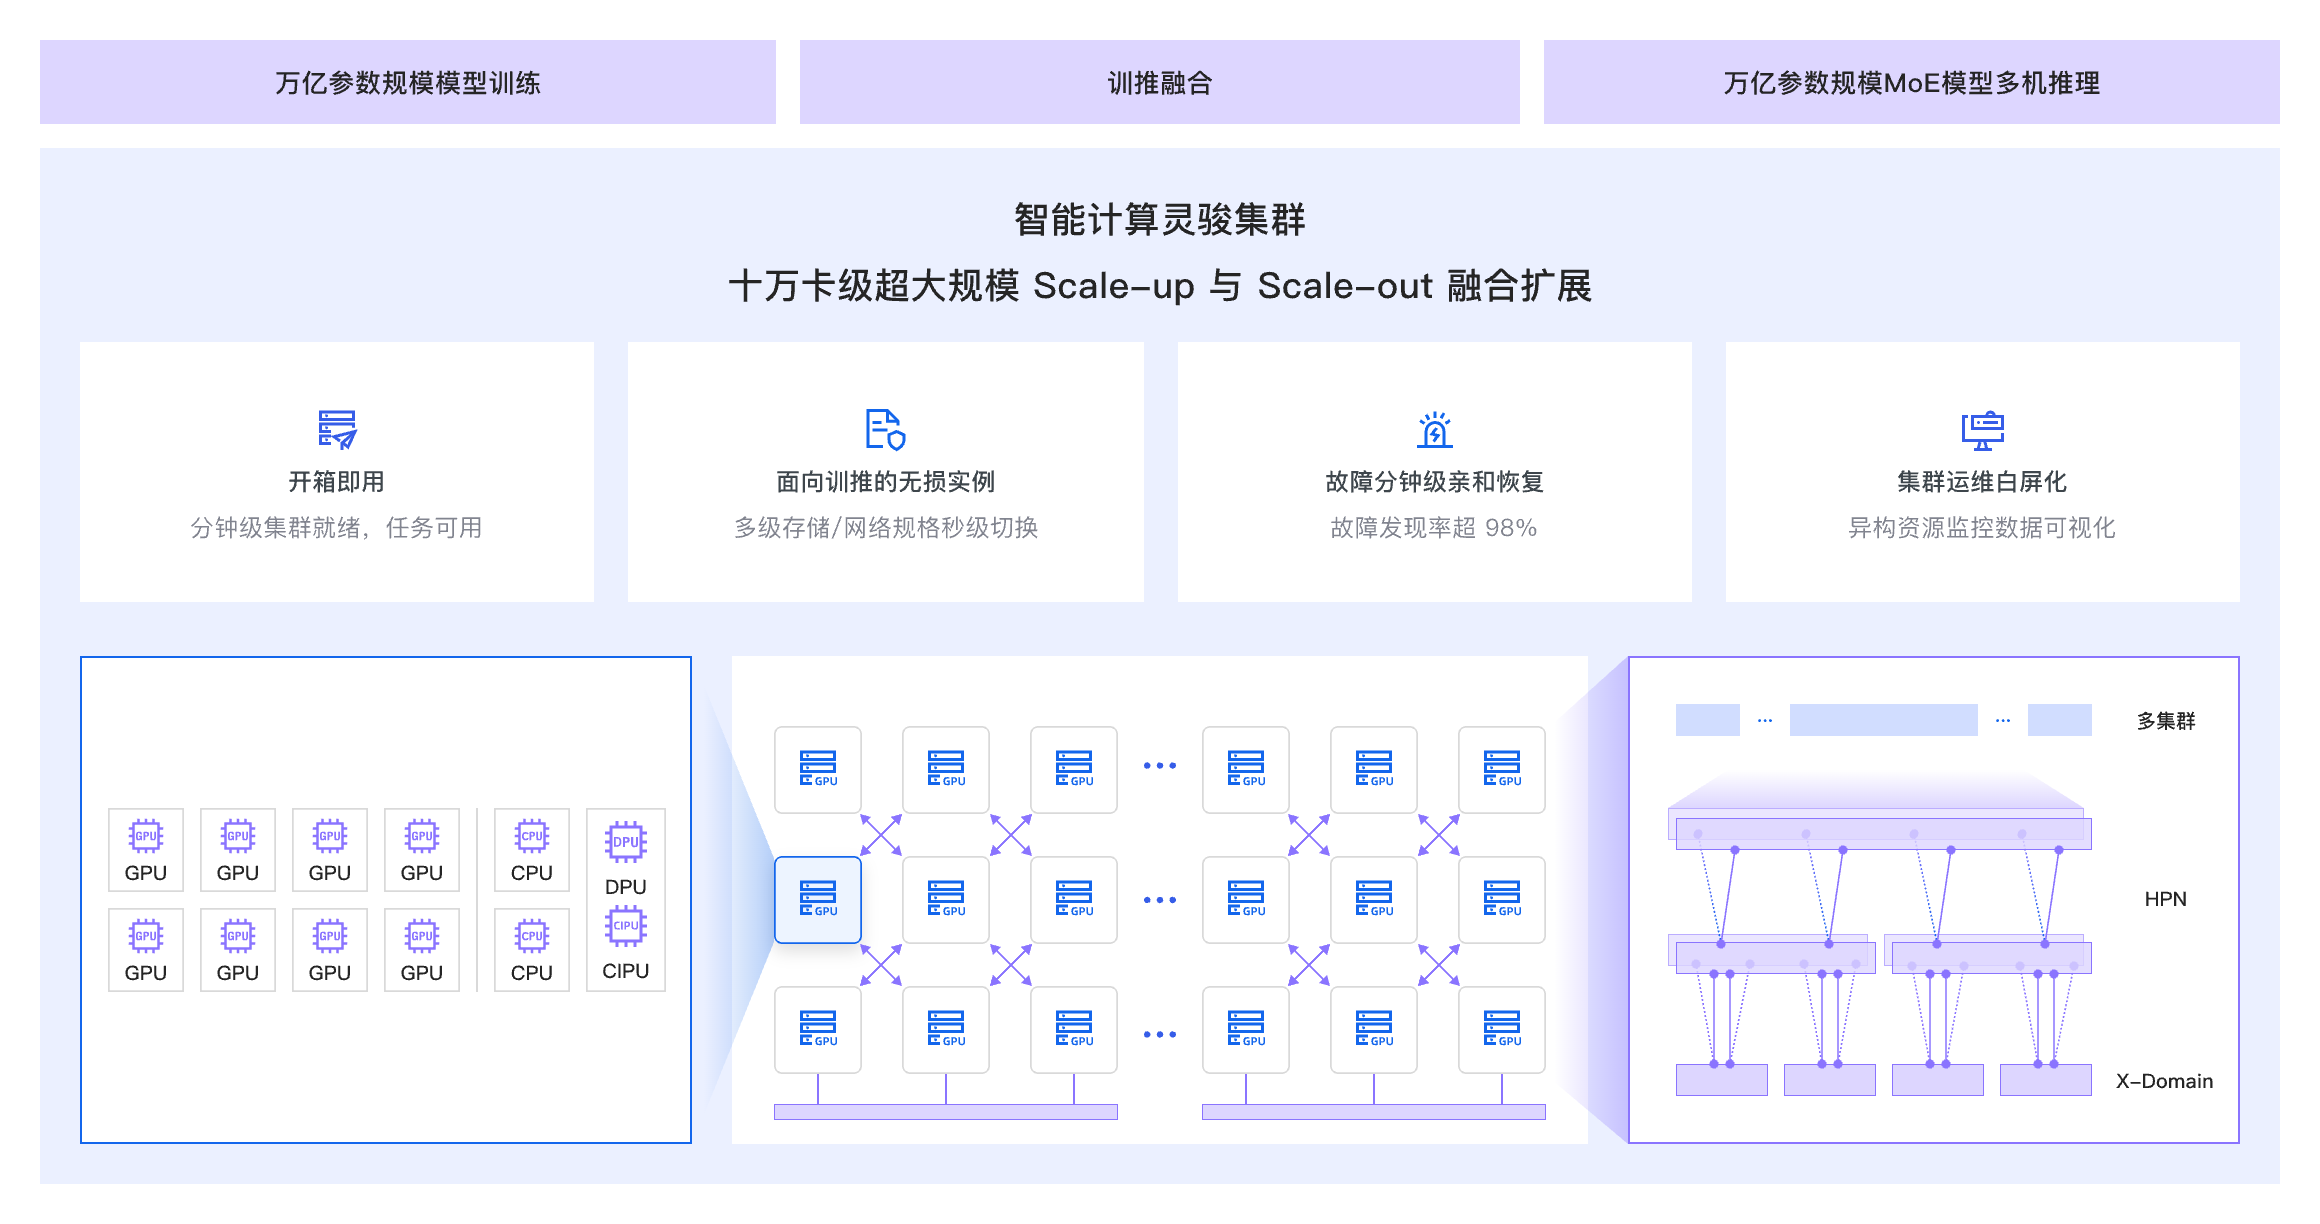
训推融合的超大规模集群
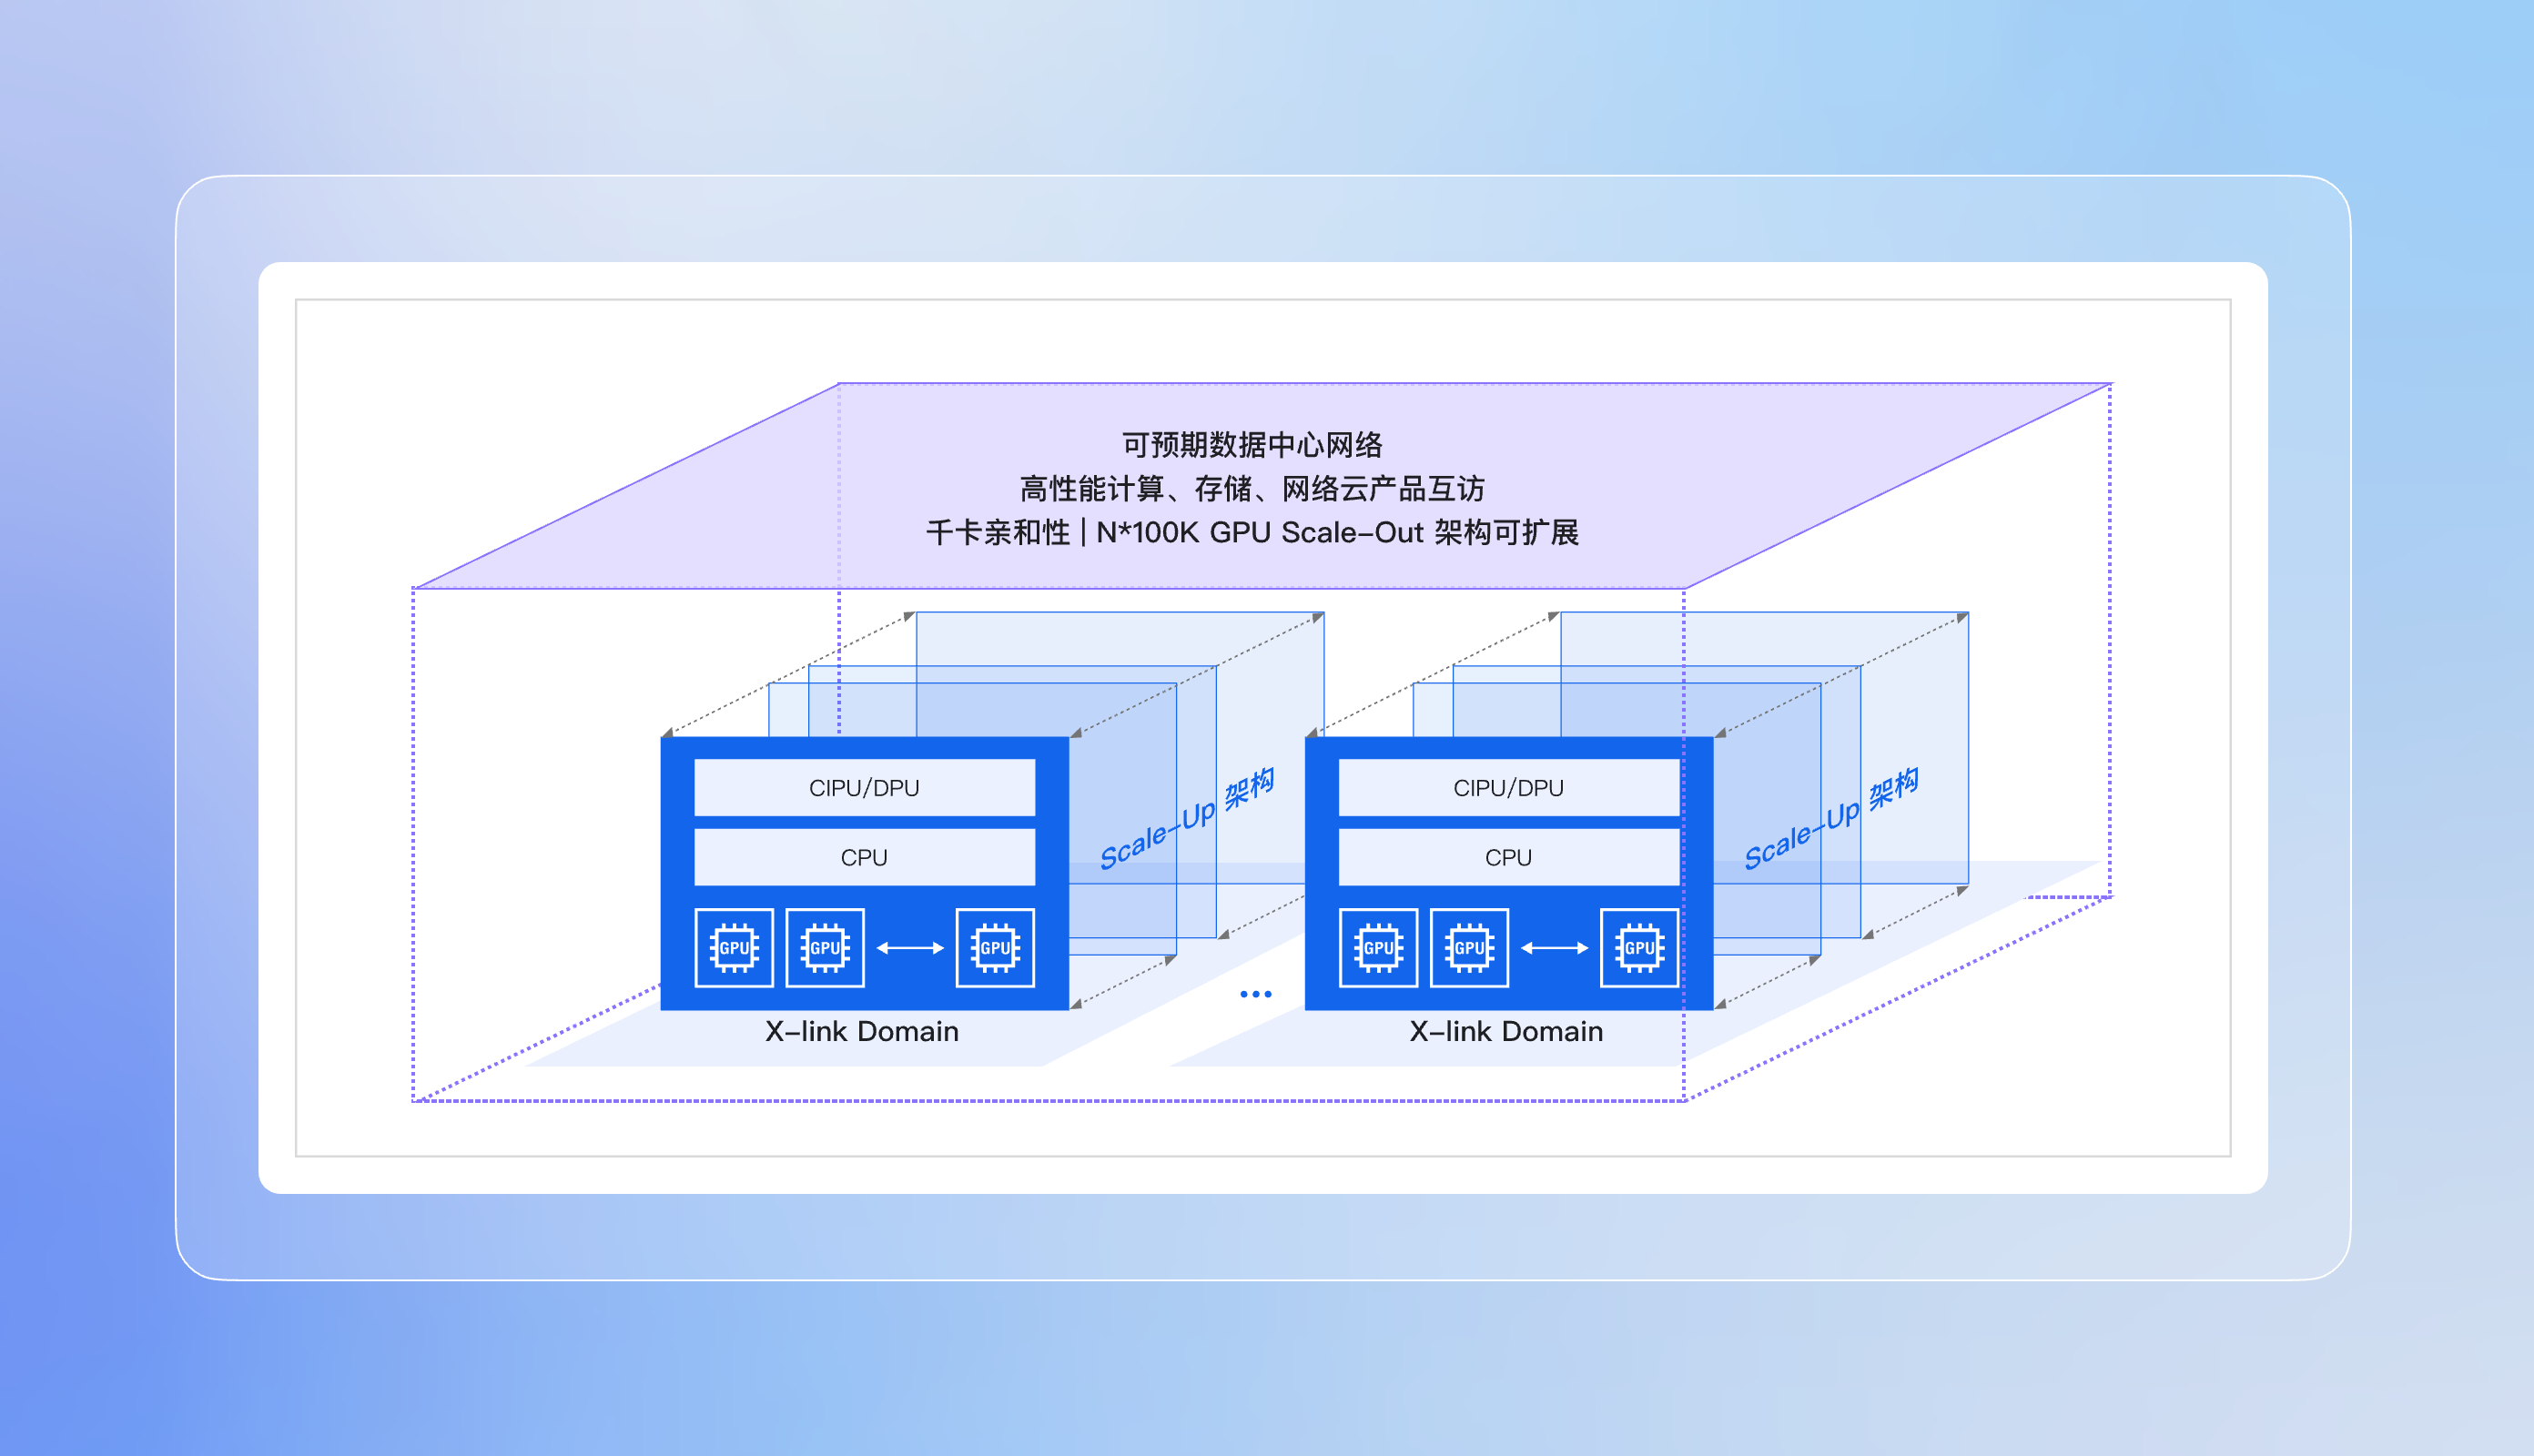
专为当下与未来AI大模型设计,支持十万卡级大规模集群快速部署与管理,兼容主流深度学习框架。灵骏采用高性能网络架构(HPN, High Performance Network)解决扩展性难题,单层网络可以实现千卡级扩展,两层网络可以实现万卡级扩展,具备高可扩展性与强稳定性,为AGI时代的大模型研发提供强大算力支撑。
稳定可靠
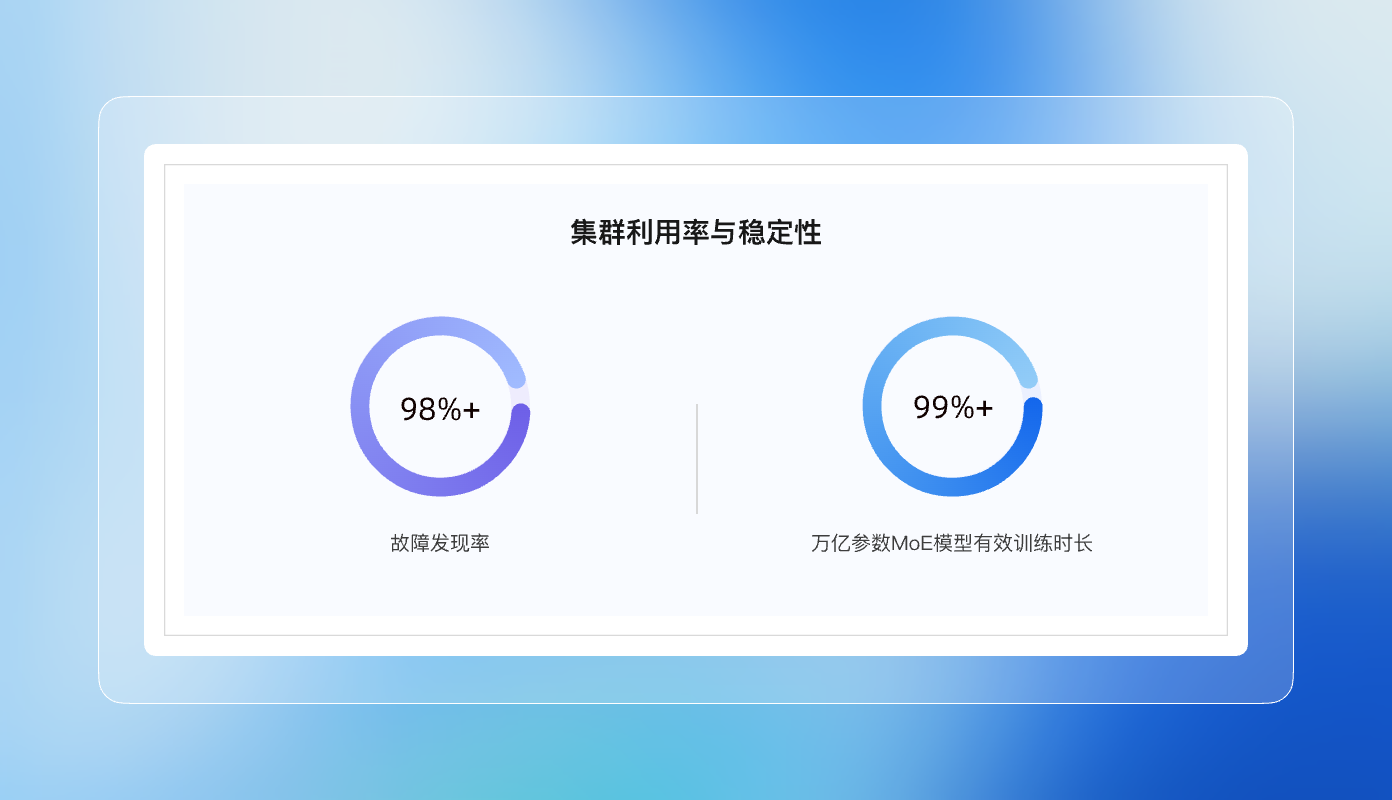
基于任务并行策略,通过硬件架构与平台层软件对稳定性进行云产品联动自愈设计与系统性的优化,提供精细化的故障事件发现能力,支持对节点、GPU卡、调度服务等各层面健康状态实时监控与异常处理,降低故障发生概率和故障影响面,提升任务的鲁棒性。整体具备分钟级的故障亲和恢复能力,故障发现率超98%,有效支撑万亿参数MoE大模型训练获取超过 99%训练有效时长。
多种形态灵活的存储搭配
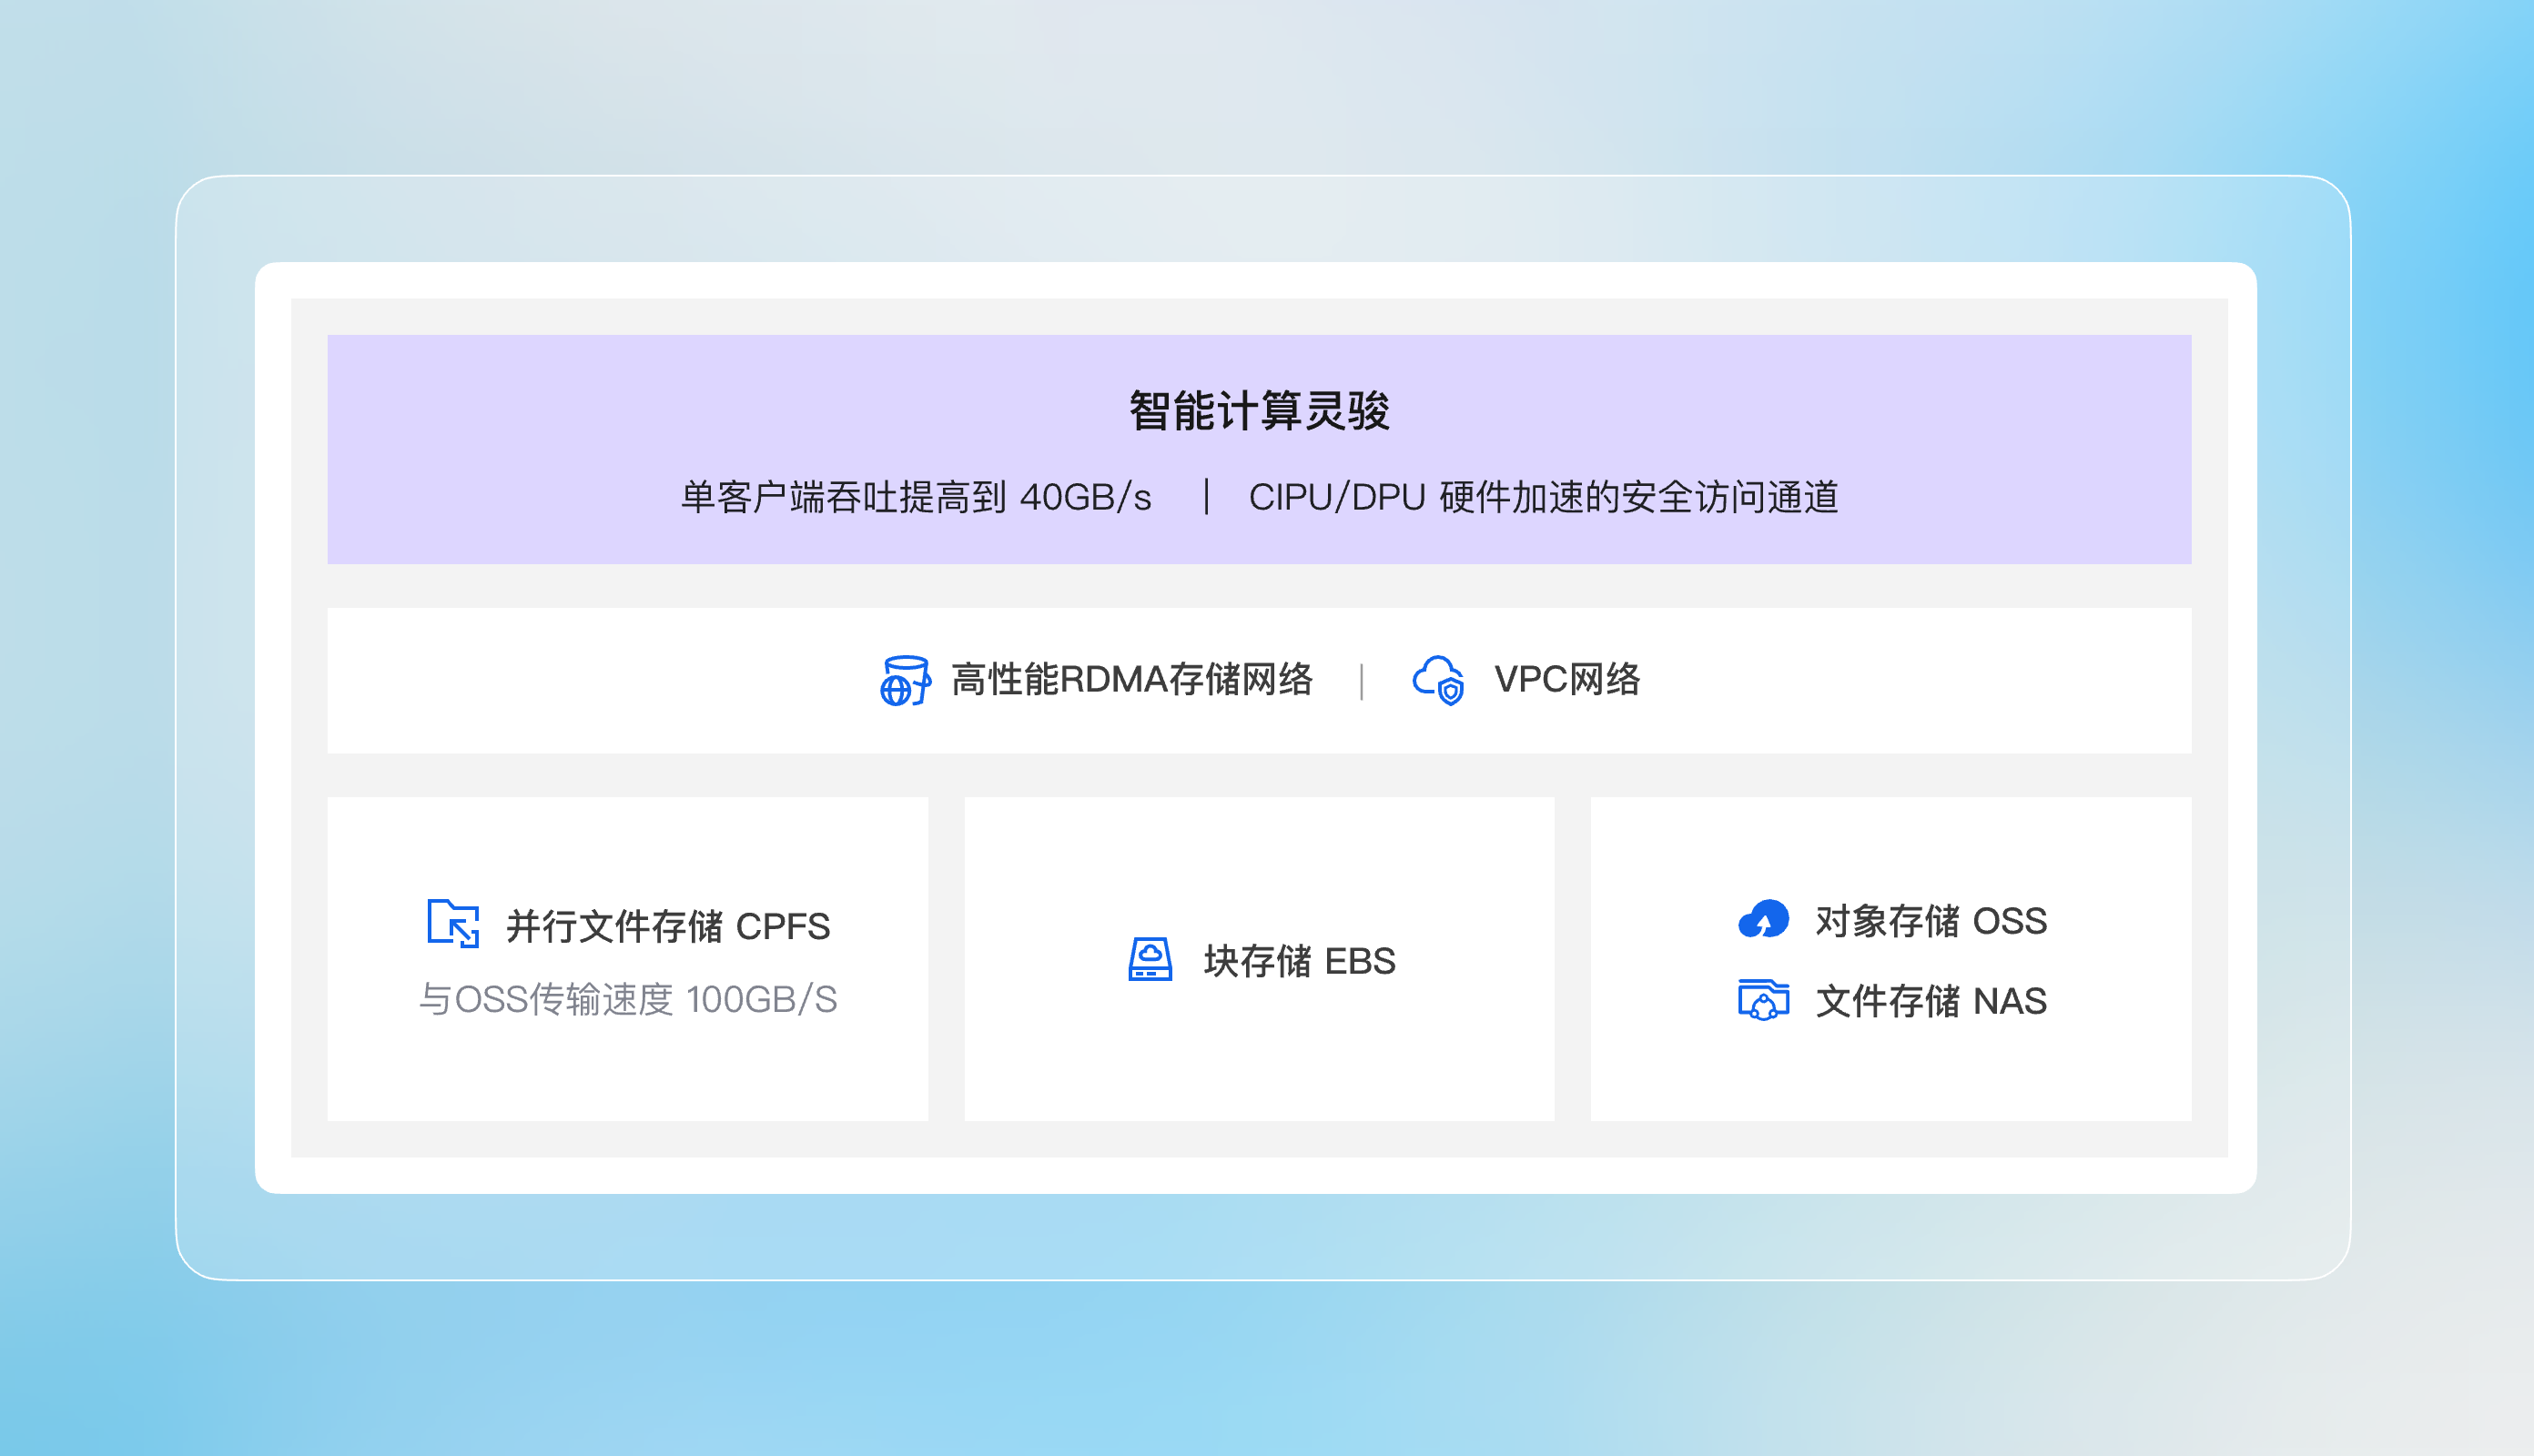
通过 RDMA 高吞吐、低延迟的数据访问通路,利用分布式并行文件系统CPFS,确保万卡集群在训练过程中能持续高效地获取训练样本。利用高性能低时延的缓存能力,满足数据预加载、Checkpoint存储等场景的存储性能要求,同时可以结合EBS、OSS等产品,满足块、对象等多规格、多类型的数据存储需求。可通过快速规格切换实现不同的存储访问模式,无需退租。存储流量和计算流量分离,支持异步checkpoint集群级通信优化,避免存储流量干扰计算流量造成并行通信抖动。
算力基石
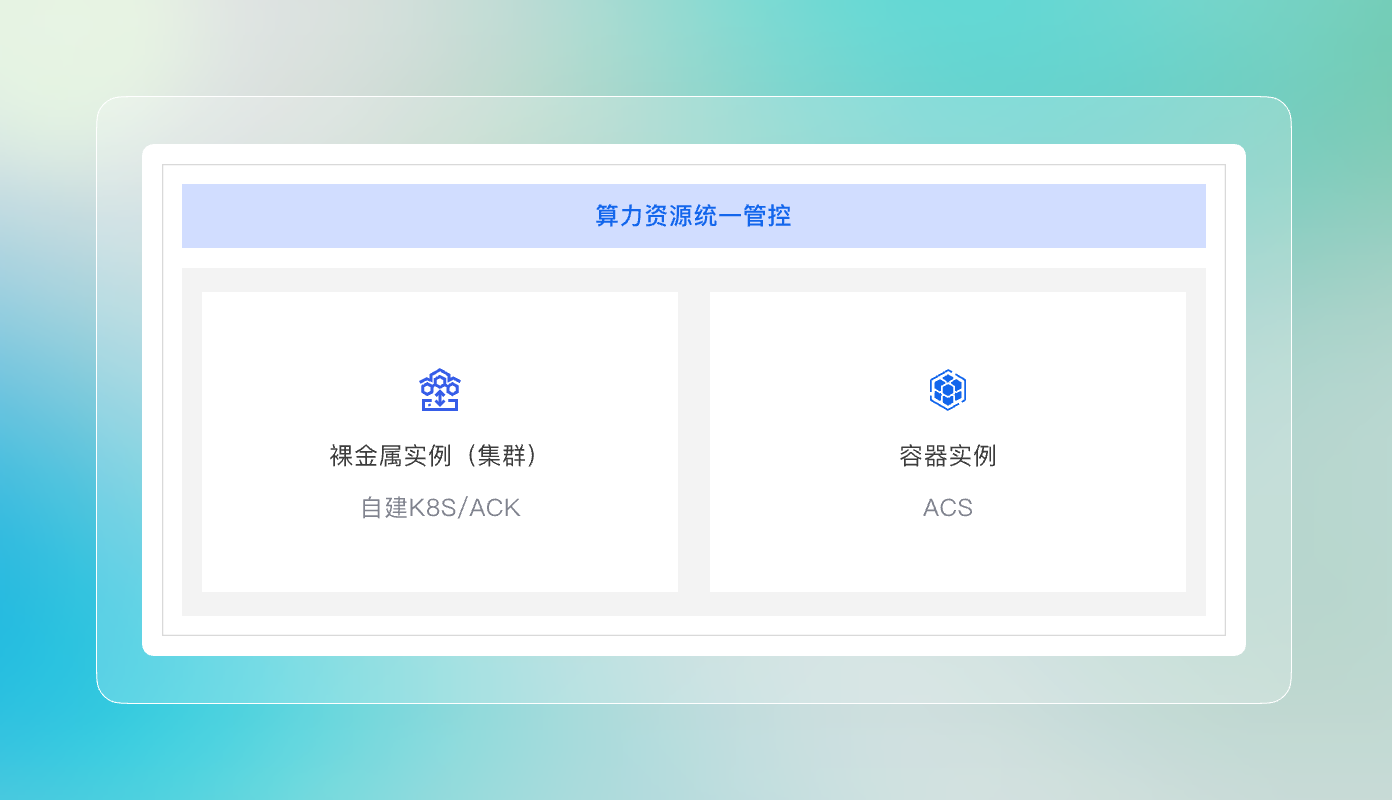
提供裸金属实例(集群)与容器实例等算力形态,实现AI计算资源的标准化与规模化。其中裸金属实例规格,具备等效的通信互联能力,搭配最新一代CPU以及充沛的GDS数据缓存;容器实例支持标准化的K8S接口和容器网络方案,同时可结合安全容器对计算存储网络进行资源虚拟化,为上层平台应用提供池化的智能算力,部分场景资源利用率可提升3倍。
智能计算灵骏是一种稳定高效、高扩展性异构计算服务,提供网络、权限控制、容灾等维度的安全和合规能力,为客户打造可信的智能计算底座。
网络隔离
容灾恢复

访问控制


