
构建全模态数据的 Agentic Lakehouse
全模态数据加工与向量检索的业务挑战
在以具身智能与智能驾驶为代表的物理 AI 时代,企业每天都在沉淀 PB 级的图像、视频、点云、语音与传感器数据。要让这些数据真正驱动模型训练、Agent 决策与车队闭环,必须完成两件事:一是将原始多模态文件加工为可被检索的高质量向量,二是让上层应用以毫秒级在向量与结构化数据上完成联合分析。然而,传统自建链路普遍面临以下挑战。
多模态数据的向量化加工(文本 Embedding、图片转向量等)往往散落在自建 PyTorch 推理脚本、独立向量库导入工具与定时 ETL 之间,缺少统一的批/流加工框架,难以承载车队每日数十 TB 的增量。
原始多模态文件存在 OSS,向量存在独立向量库,元数据再单独维护,导致样本版本、标签版本、向量版本三套口径,回灌训练时极易"对不齐"。
自建向量数据库需要预置大规格 GPU/内存机型,业务高峰扩容慢、低谷资源闲置;亿级向量 + 复杂结构化过滤的混合查询,往往要在多套系统间来回搬数据。
车端数据涉及道路、人脸、车牌等高敏内容,跨部门共享时缺少统一的湖上权限、血缘与脱敏机制,难以满足汽车数据安全与具身智能合规审计要求。
Agentic Lakehouse 方案优势全景
基于 EMR Serverless Spark 原生支持图像/视频/音频/文本多模态数据的批流加工,内置 Embedding 与图片转向量算子,无需自建 GPU 推理集群即可完成 PB 级向量化。
通过阿里云 DLF 统一管理原始文件、向量列与业务元数据,向量与结构化属性共用一份湖上数据,避免"文件湖 + 向量库 + 数仓"三套口径,天然支持版本回溯与训练样本快照。
EMR Serverless StarRocks 提供原生向量索引与向量+标量混合查询能力,亿级向量毫秒级召回,支撑相似场景检索、Corner Case 挖掘、车队回灌等高并发在线分析。
向量检索与结构化分析统一以 SQL/REST 暴露,天然适配 LangChain、Dify、自研 Agent 框架,让大模型 Agent 直接"看见"企业全模态数据,构建真正的 Agentic Lakehouse 闭环。
全 Serverless 架构,让多模态数据一次入湖、即刻可查
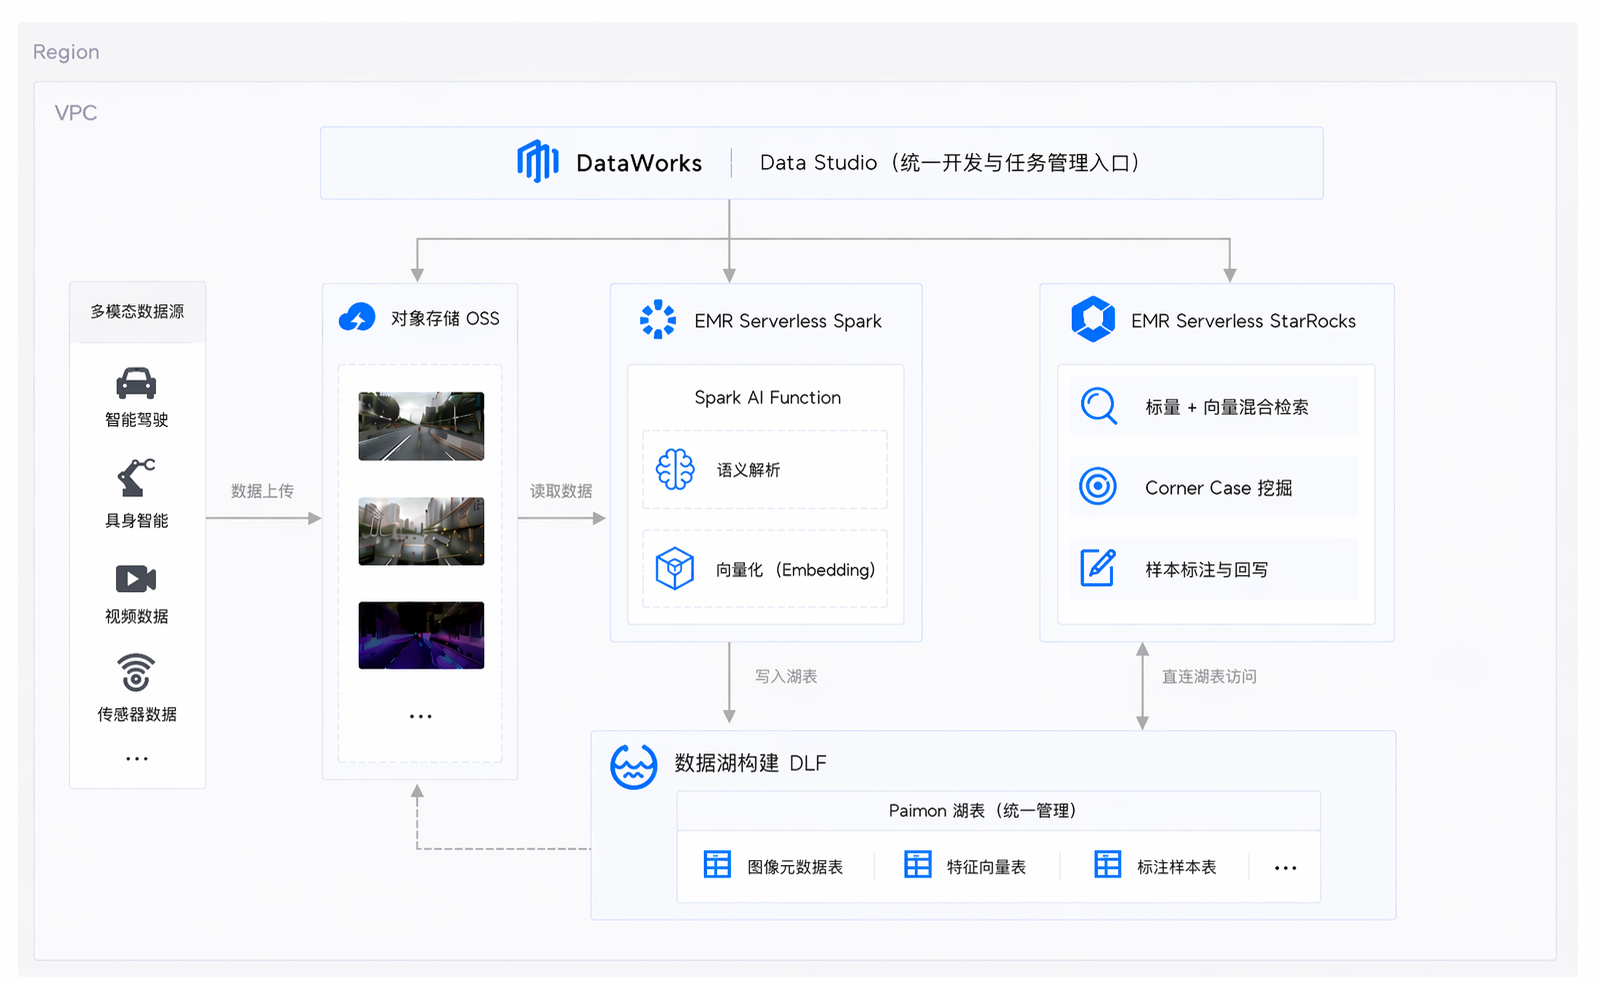
本方案基于 EMR Serverless Spark 读取 OSS 中的原始多模态数据(图像),经内置 Embedding 模型与图片转向量 UDF 完成向量化,连同业务属性写入 DLF 统一管理的 Paimon 湖表;EMR Serverless StarRocks 直接读取湖表并构建向量索引,对外提供“向量召回 + 标量过滤 + 聚合分析”的统一 SQL 接口;上层 Agent、训练平台与可视化应用通过 JDBC/REST 接入即可。
技术方案的广泛应用场景
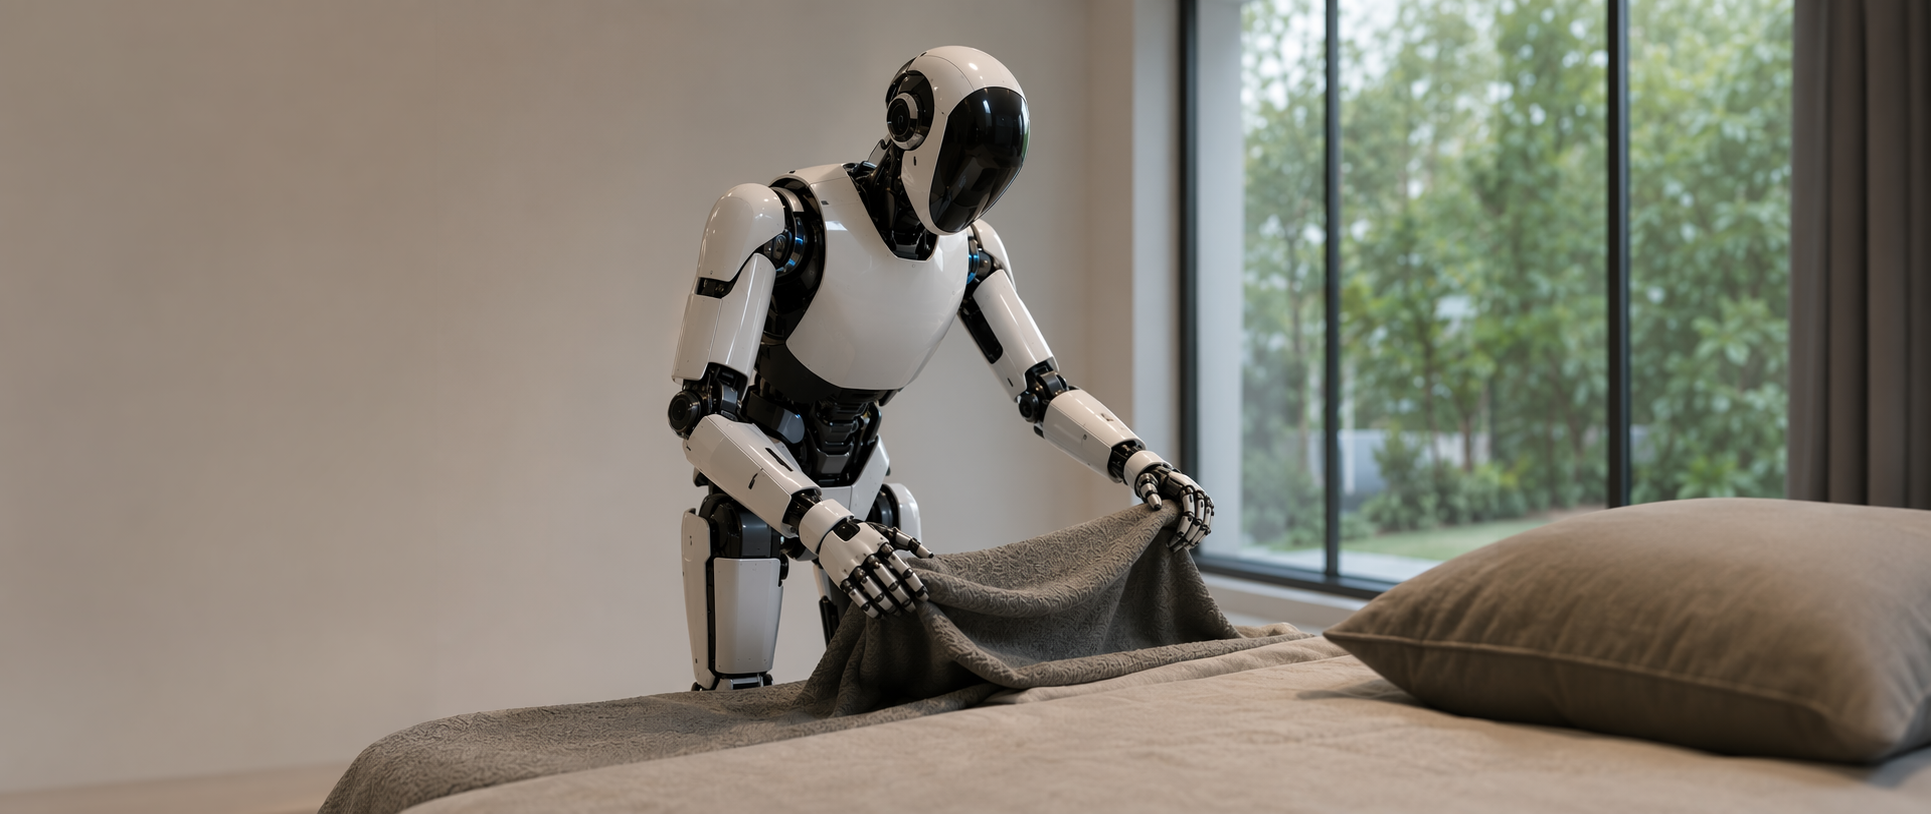
具身智能训练样本挖掘
机器人每日回传的海量视觉与动作数据统一向量化入湖,支持“以图搜动作、以姿态搜场景”,分钟级筛出高价值训练样本,加速模仿学习与强化学习迭代。
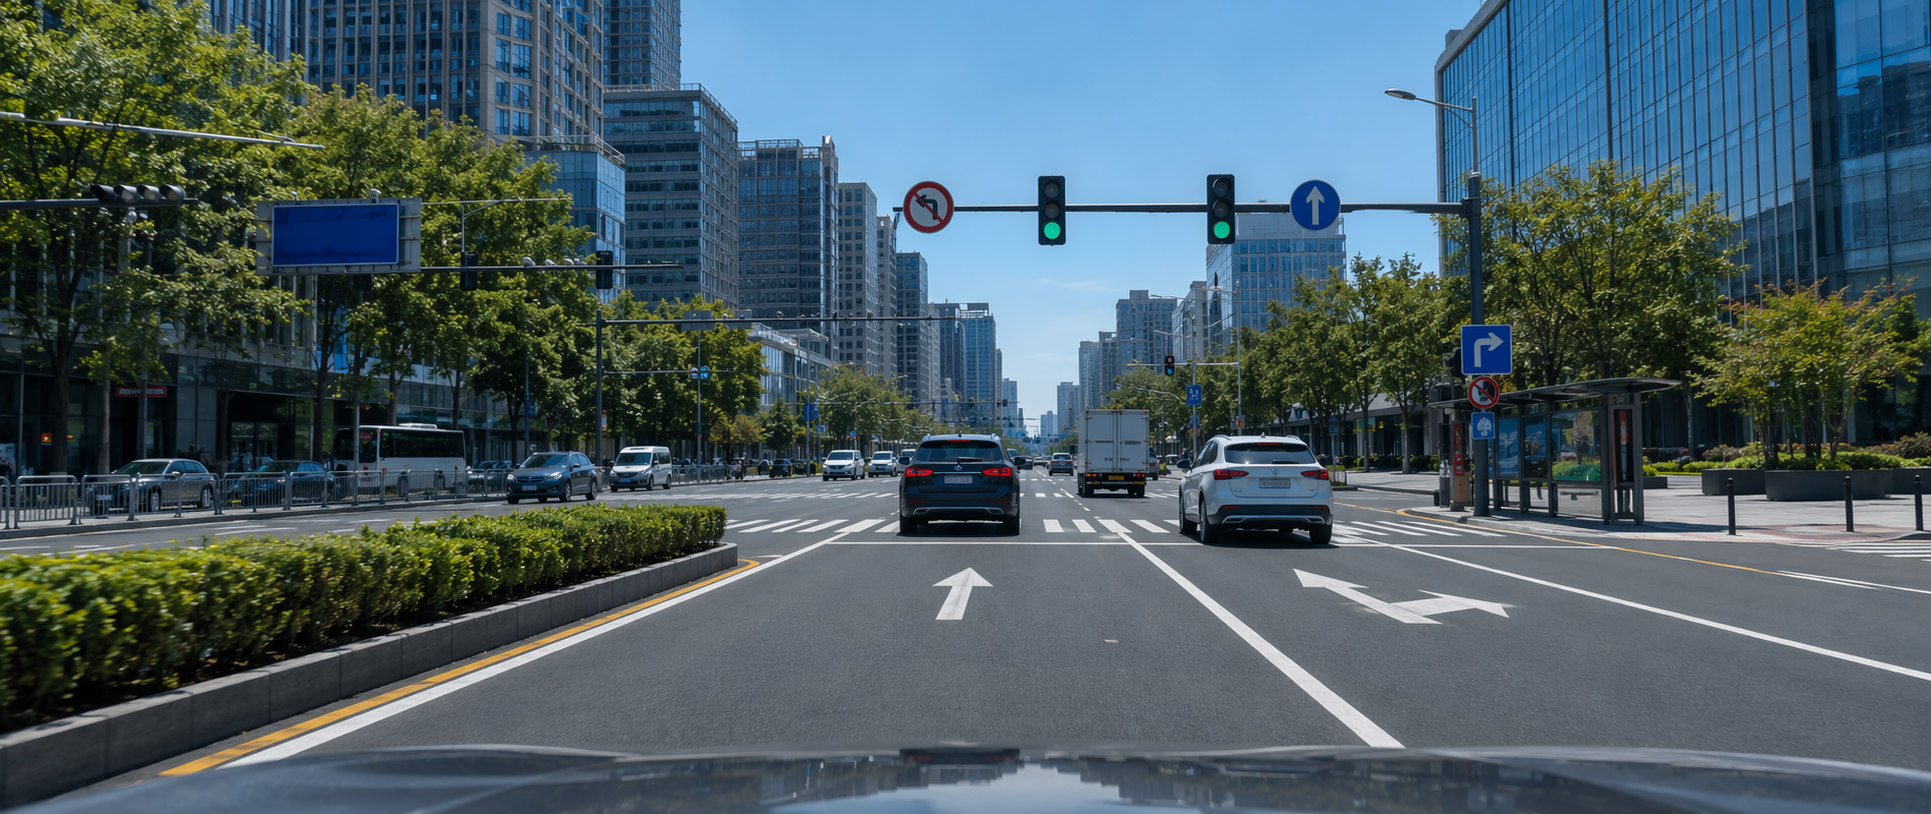
智能驾驶 Corner Case 挖掘
车端图像与点云经 Spark 向量化落入 DLF 湖表,StarRocks 一次混合查询完成相似 Corner Case 召回与车型、路况、时间过滤,支撑数据闭环与针对性回灌训练。
多模态 Agent 与 RAG 应用
企业图文、产品图、培训视频统一 Embedding 入湖,Agent 通过一次 SQL 完成向量召回与业务过滤,构建多模态 RAG 应用,让大模型真正“看到”企业知识。