
Qwen Audio:打造专属 AI 语音助手
语音AI交互的技术瓶颈与突破
传统语音模型往往只能进行简单的聊天交流而无法执行具体任务,存在“能聊天不能办事”的功能局限性,这种局限性严重制约了语音AI在商业场景中的实际应用价值。
行业长期在“快速响应”与“准确推理”之间面临选择困境,要么响应快速但答非所问,要么逻辑严密但等待时间过长,这种二选一的局面无法满足现代实时交互应用的需求。
该模型采用“听思同步”架构,语音输入与语义推理并行,实现毫秒级端到端响应。在保持低时延的同时未牺牲深度推理能力,为智能座舱、实时客服等高交互场景提供可用的实时语音 AI 底座。
全栈智能语音交互新范式
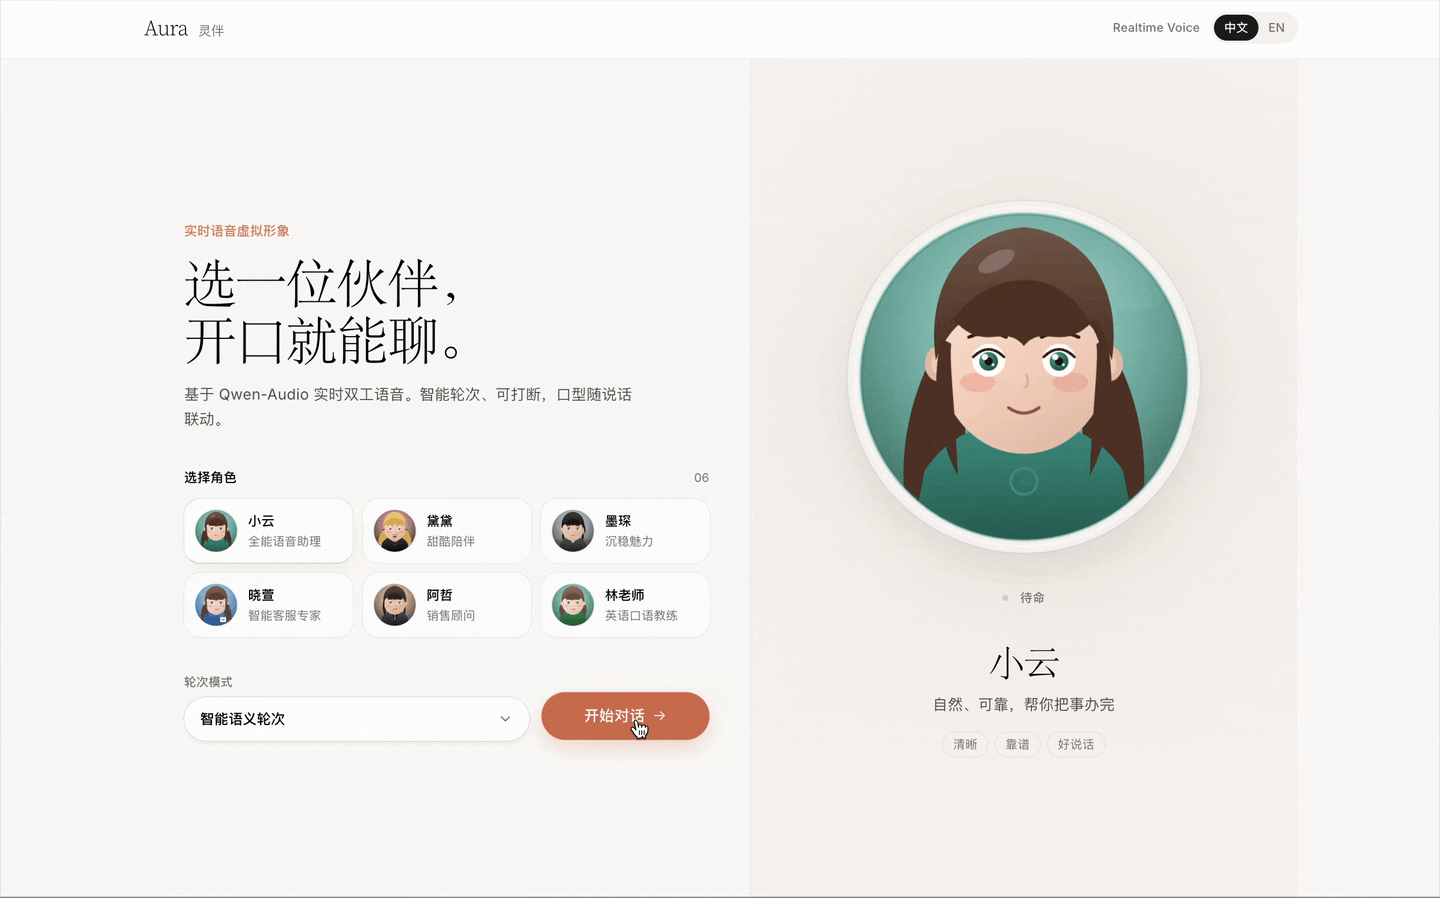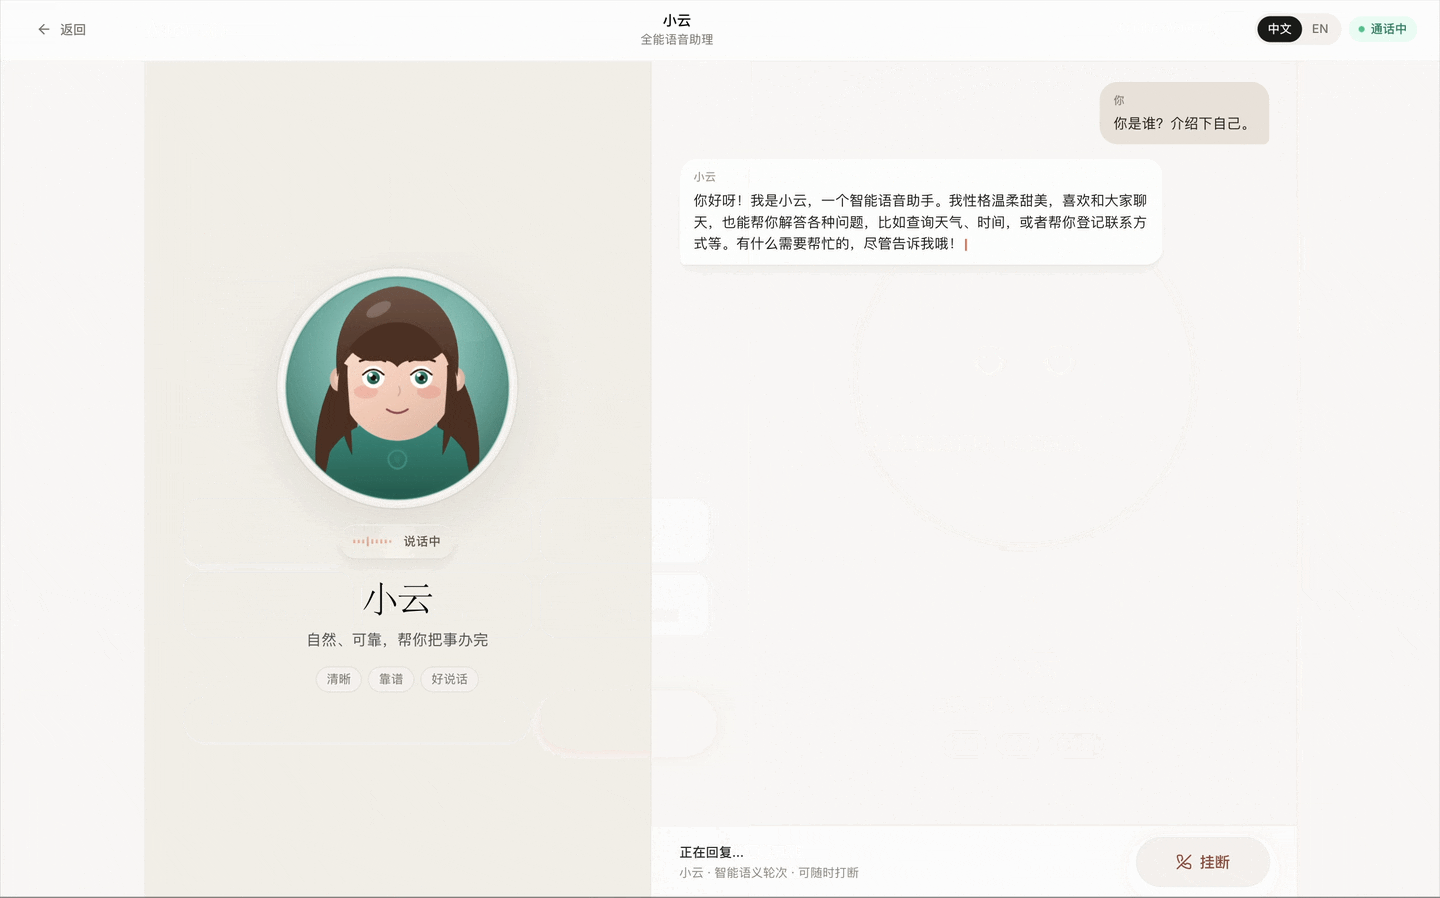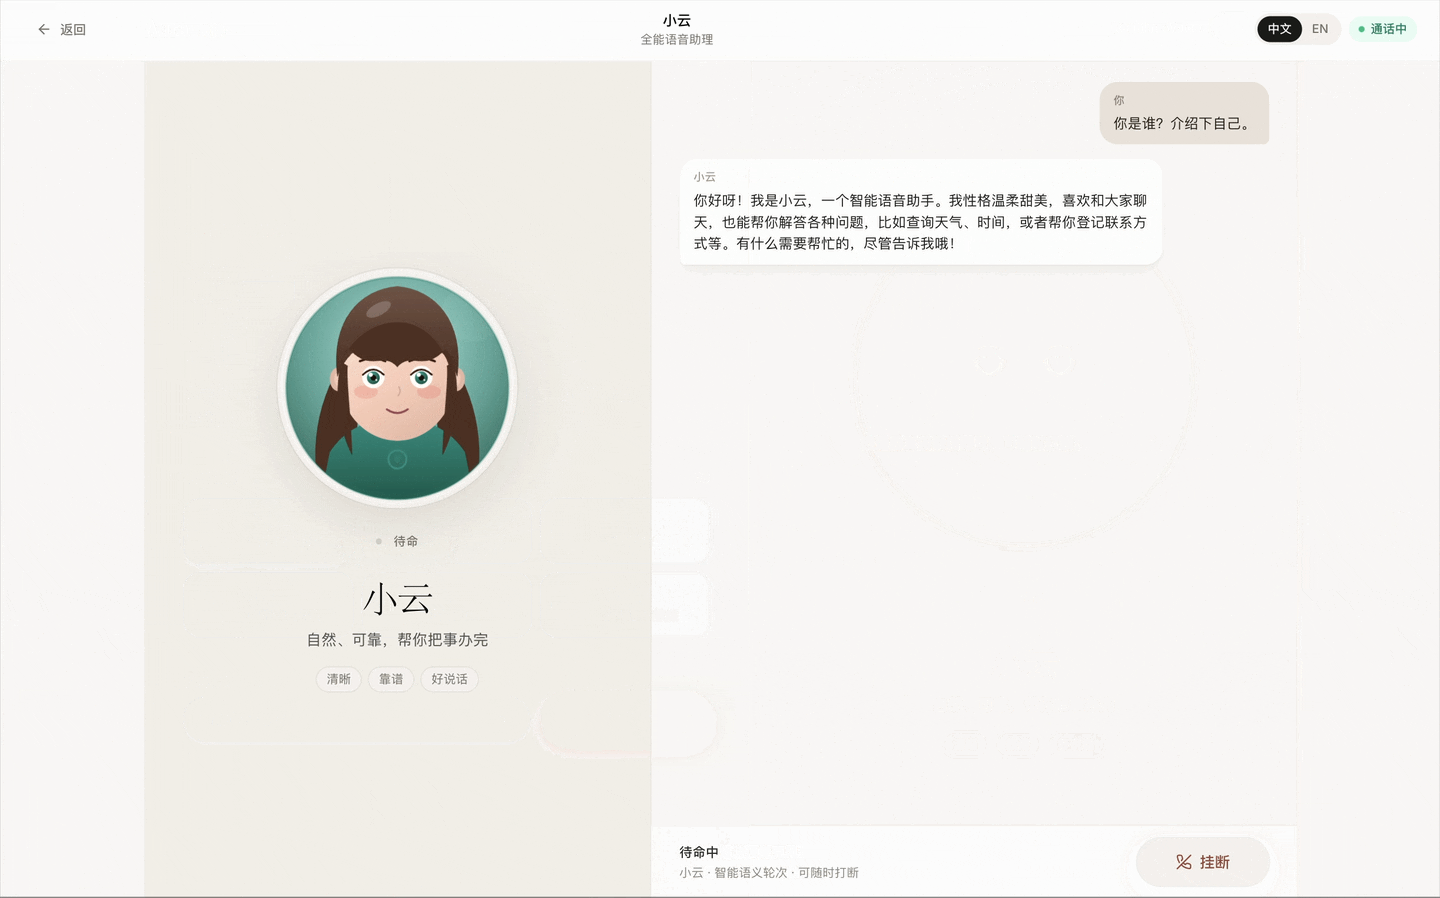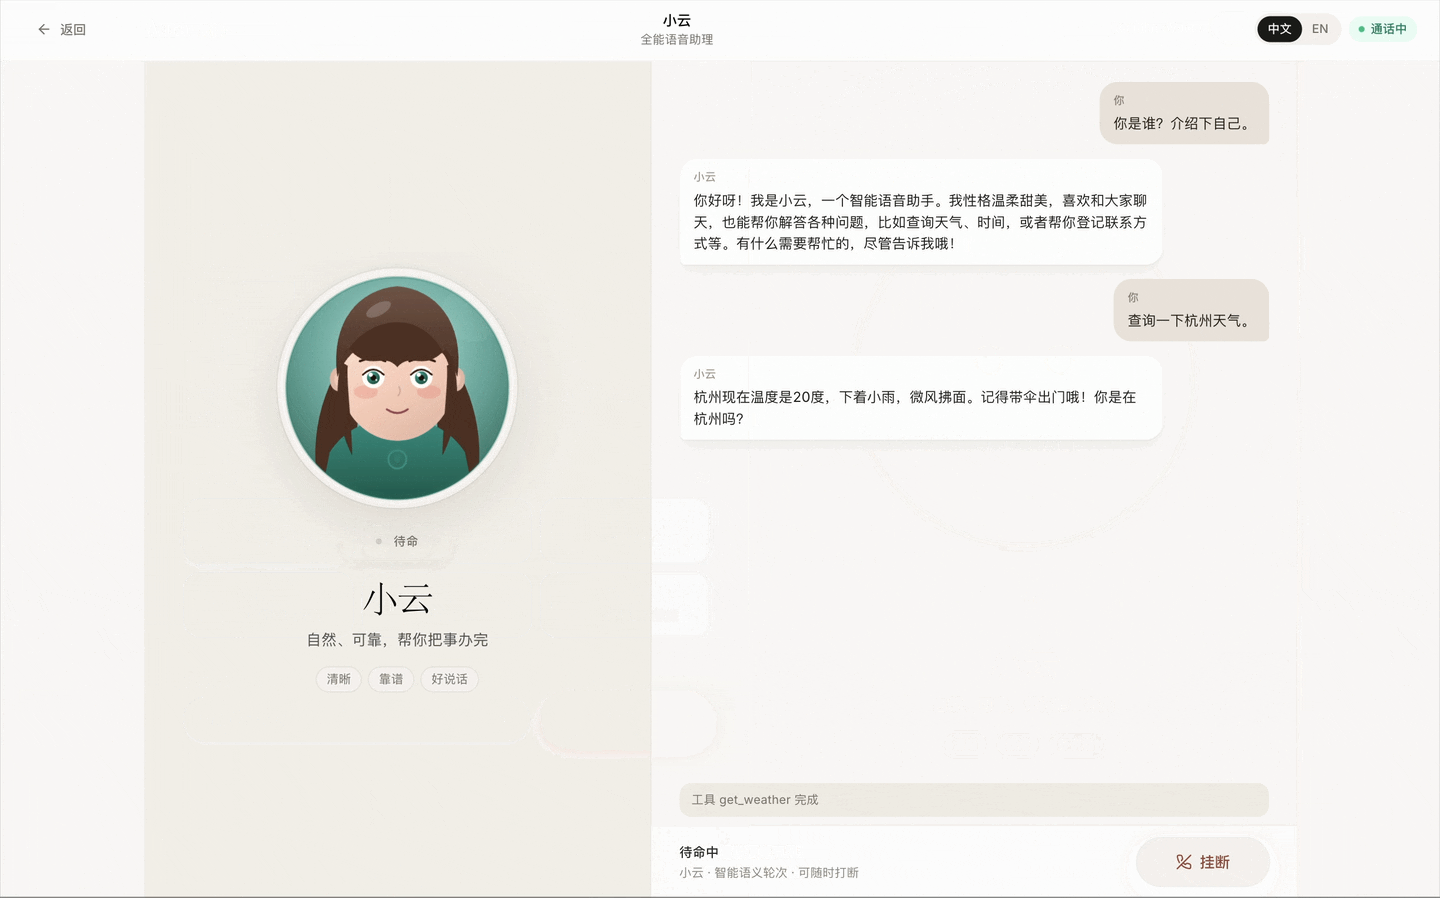
智能Agent工具自主调用
模型无需明确指令即可自行调用外部工具,调用结果会自动融入对话记忆,支持后续多轮追问中的持续使用,基于 FunctionCall 标准协议可以完成 MCP、API 及知识库的引入。
多模态情感共情对话
摆脱传统语音助手的机械感,可根据对话语境动态调整语气、节奏、音调与情感表达,在辩论场景中能准确抓取对方论点并快速组织反驳,在情感陪伴中通过语调、节奏与副语言信号进行共情回应。
全双工流式交互体验
内置“多模态感知的双工控制”子模型,通过分析音频信号、语义内容与说话人声纹特征来判断如何交谈,在嘈杂环境中不会被背景噪声误打断,在多说话人场景中能锁定主对话对象并忽略旁听者。
毫秒级实时响应性能
采用并行推理和全向流式等工程优化,将端到端响应时延控制在低水平,针对日常对话和简单问答等对时延敏感的场景,能够直接生成回复并以毫秒级速度响应用户。
一键部署多角色 AI 实时语音通话

本方案基于阿里云 FC 与百炼平台,构建 AI 语音助手应用,实现毫秒级实时响应。原生兼容 FunctionCall/MCP 协议,真正实现从模型上线到业务集成的端到端标准化交付。
阿里云为您提供云产品免费试用
技术方案的广泛应用场景
智能客服与咨询服务
适用于电商、金融、政务等领域的智能客服场景,模型能够边听边判断何时该调工具,自动触发相关知识图谱和业务API,提供准确高效的客户服务体验。
在线教育与培训平台
在教育培训场景中提供自然的双工交互体验,支持打断续聊、多意图叠加和跨轮次指代消解,使学生能够像与真人教师一样进行自然流畅的问答互动。
情感陪伴与娱乐互动
通过第三代微表情声纹建模技术,能从语气停顿、基频抖动、共振峰偏移中识别用户情感状态,提供真正的情感共鸣而非机械回应,适用于心理健康、老年陪伴等细分领域。