
流批一体 LakeHouse 架构实践
告别孤岛与重复开发:基于 DLF 的流批一体 Lakehouse 实践
传统架构中元数据、存储、权限分散管理,跨引擎数据协同需复杂 ETL 搬运,导致数据一致性差、时效性低,企业分析决策滞后。
历史批处理与实时流处理采用不同技术栈,需维护两套计算逻辑和存储系统,开发成本高且结果口径不一致,严重制约数据驱动业务创新。
DLF 实现元数据、存储、权限三层统一,Paimon 提供流批一体数据湖格式,结合 Flink 或 Spark 引擎形成完整 Lakehouse 方案。
高效智能的数据治理与一体化处理解决方案

统一元数据智能治理
DLF 全托管元数据服务自动同步 OSS、MaxCompute 等 30+ 数据源元信息,构建全局数据目录,智能推荐数据关联关系,治理效率大幅提升。
湖上流批一体处理
基于 Paimon 统一存储层,Flink 实现流式增量计算,Spark 支持批量历史分析,共享相同数据口径与事务一致性,避免重复开发,资源利用率提升。
开放 Lakehouse 架构
DLF 统一管理 Paimon/Iceberg/Hudi 多格式数据湖,支持 ACID 事务与时空查询优化,单集群承载 PB 级实时 + 历史数据,TPC-DS 性能达传统数仓数倍。
全生态无缝集成
原生对接实时计算 Flink版、EMR(Spark/StarRocks)、MaxCompute 等引擎,支持 Python/Java 多语言开发,提供 Serverless 按需计费模式,运维成本大幅降低。
基于实时计算 Flink 与 StarRocks 的高效数据湖分析
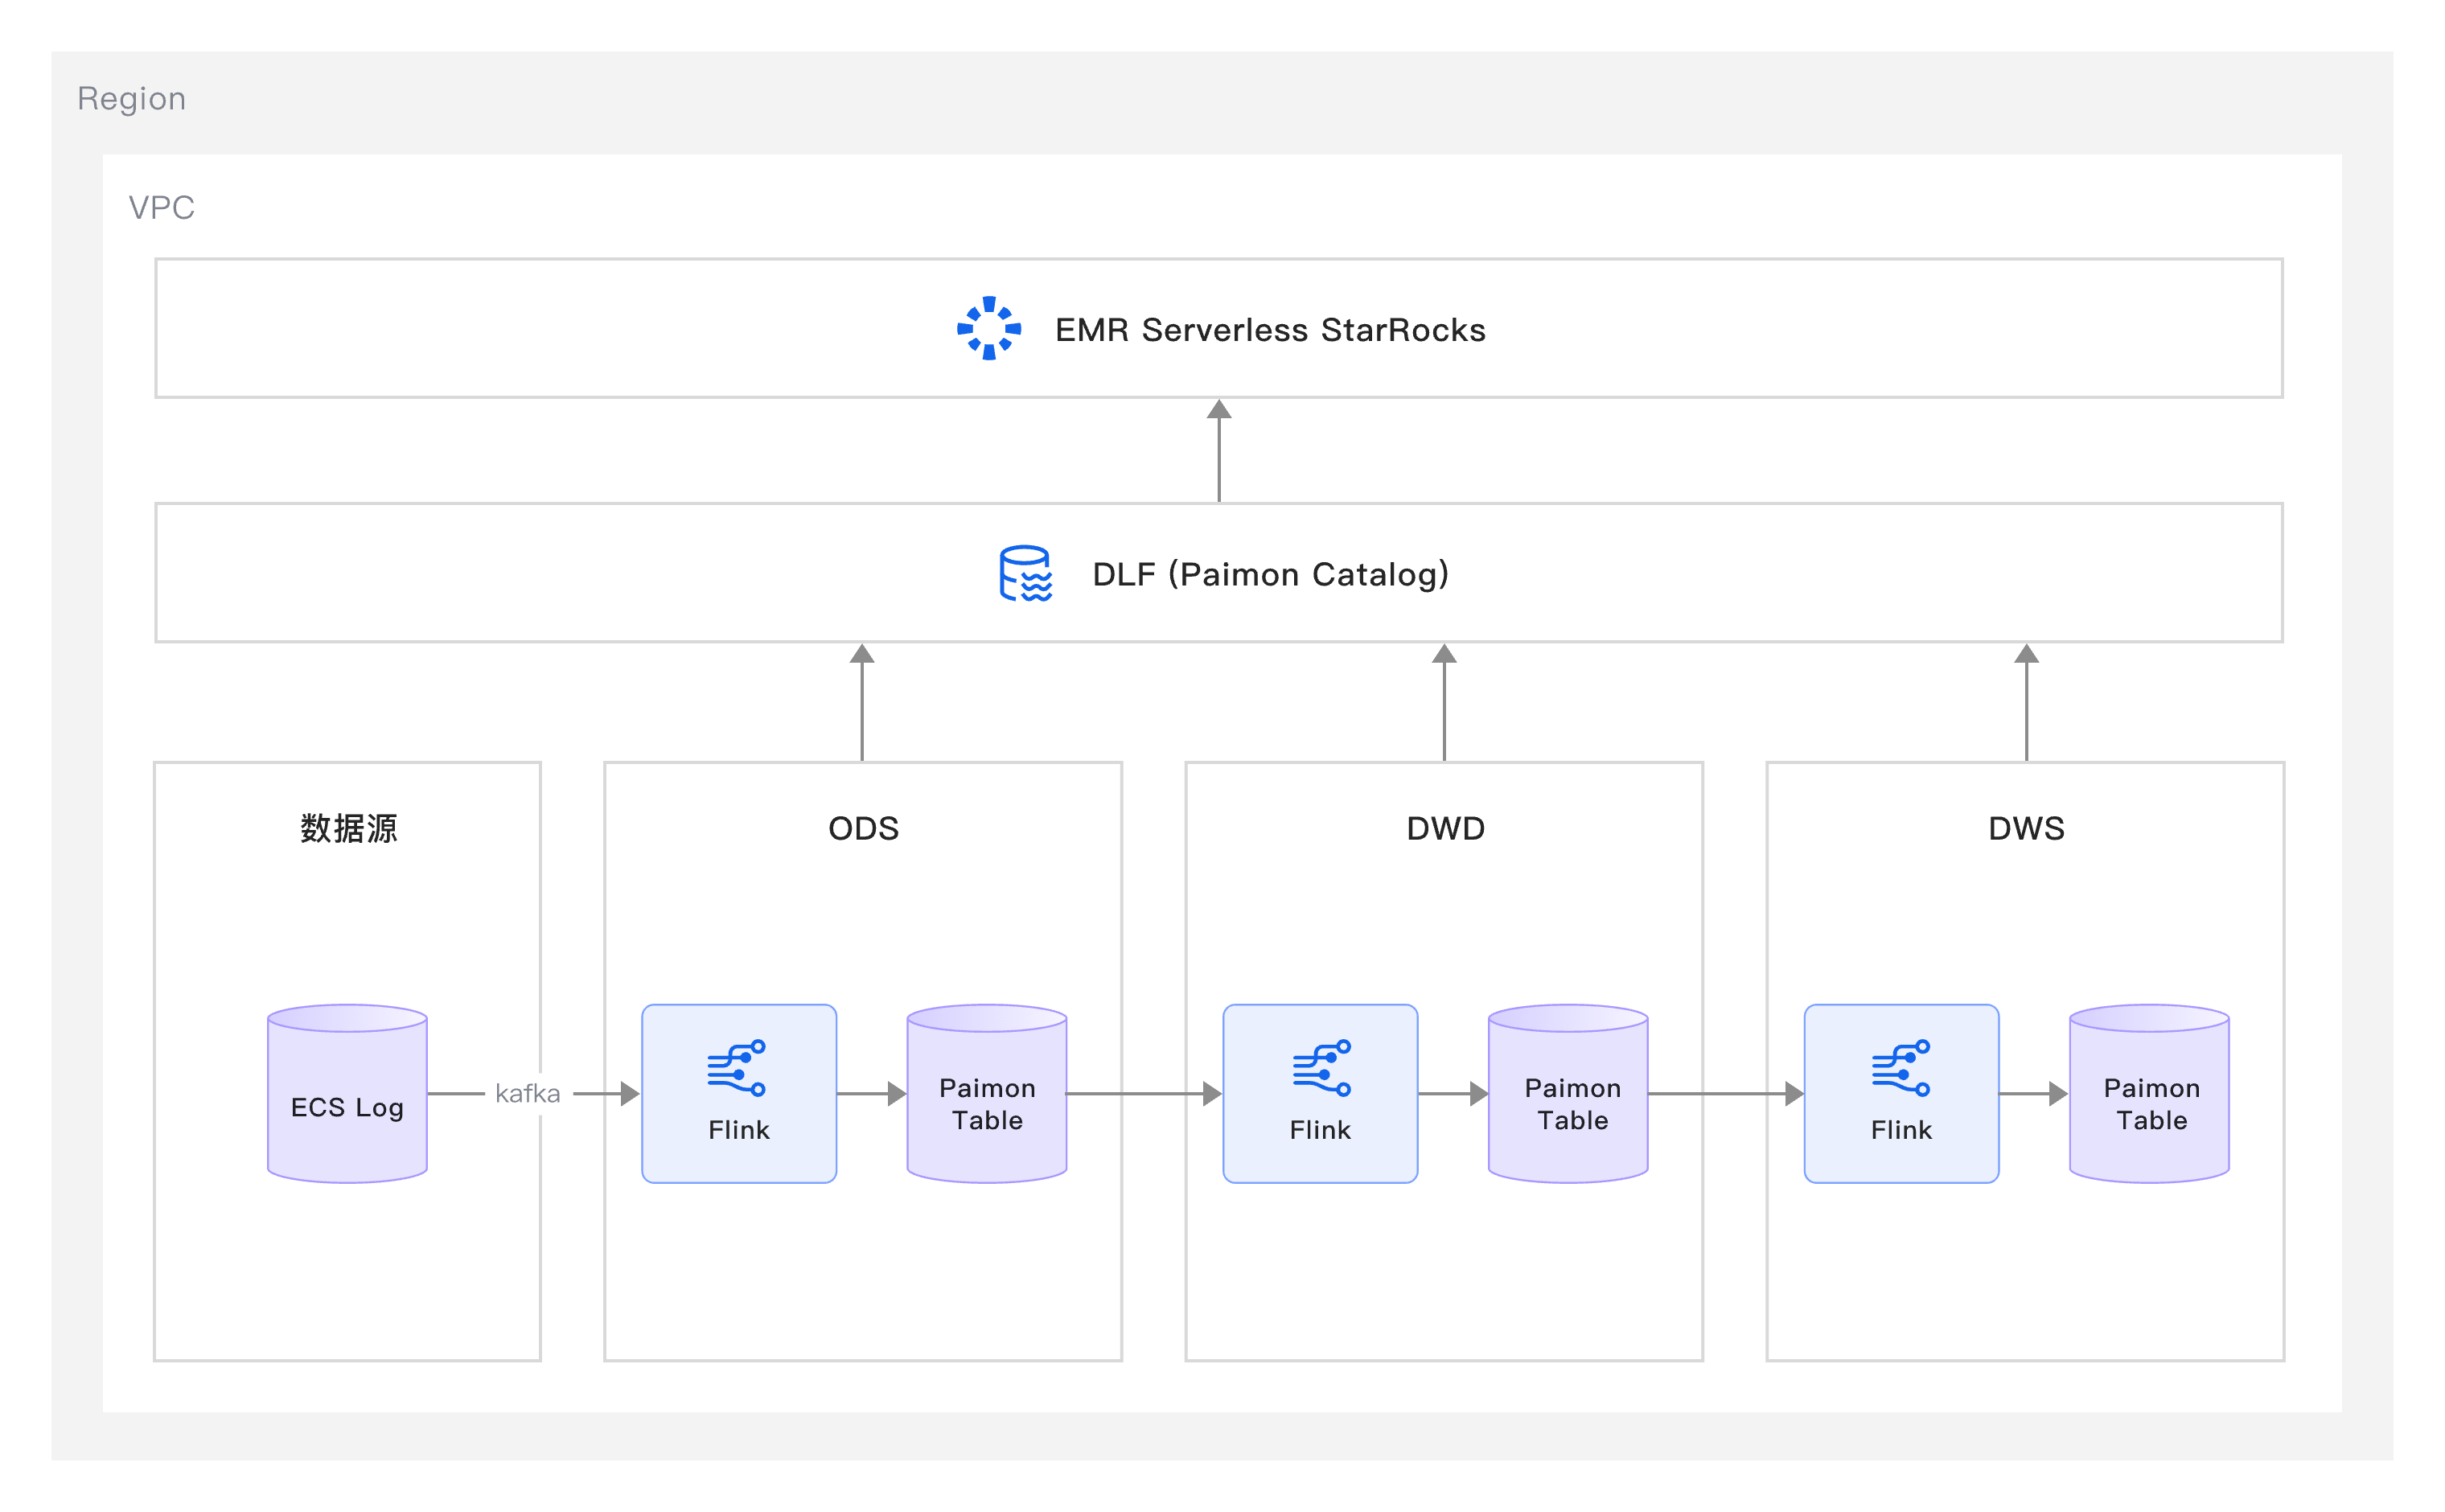
本方案基于 ECS 实例下载 GitHub Events 公开数据集,处理后写入 Kafka。通过实时计算 Flink 消费 Kafka 数据,流式写入 DLF 的 Paimon 表,形成实时 ODS 层。再使用 Flink 批处理对 ODS 层数据进行清洗、聚合与建模,构建离线 DWD 明细层。最后,利用 StarRocks 创建外部 Catalog 直连 DLF 中的 Paimon 表,实现对湖内数据的高效探查与分析,例如 GitHub 活跃项目、开发者及高星项目等场景的快速查询洞察。
技术方案的广泛应用场景

湖仓数据分析加速
DLF 与阿里云多计算引擎无缝对接,打破数据孤岛,助用户快速构建管理云原生数据湖及 OpenLake,简化运维,助力企业聚焦业务创新与数据洞察。

实时数仓分层构建
通过统一模型与简化架构,数据仓库链路基于阿里云实时计算 Flink 构建,ODS、DWD 和 DWS 层数据由 DLF 联合 Paimon 提供全托管存储,有效降低架构复杂度,提升数据处理效率。

湖上批流一体处理
Paimon 结合 Flink 提供完整的流处理能力,结合 Spark 提供完整的批处理能力。基于统一的数据湖存储,提供数据口径一致的批流一体处理,提高易用性并降低成本。